2x RTX 5060 Ti contre GB10 : pourquoi 32 Go de VRAM perdent face à 128 Go de mémoire unifiée
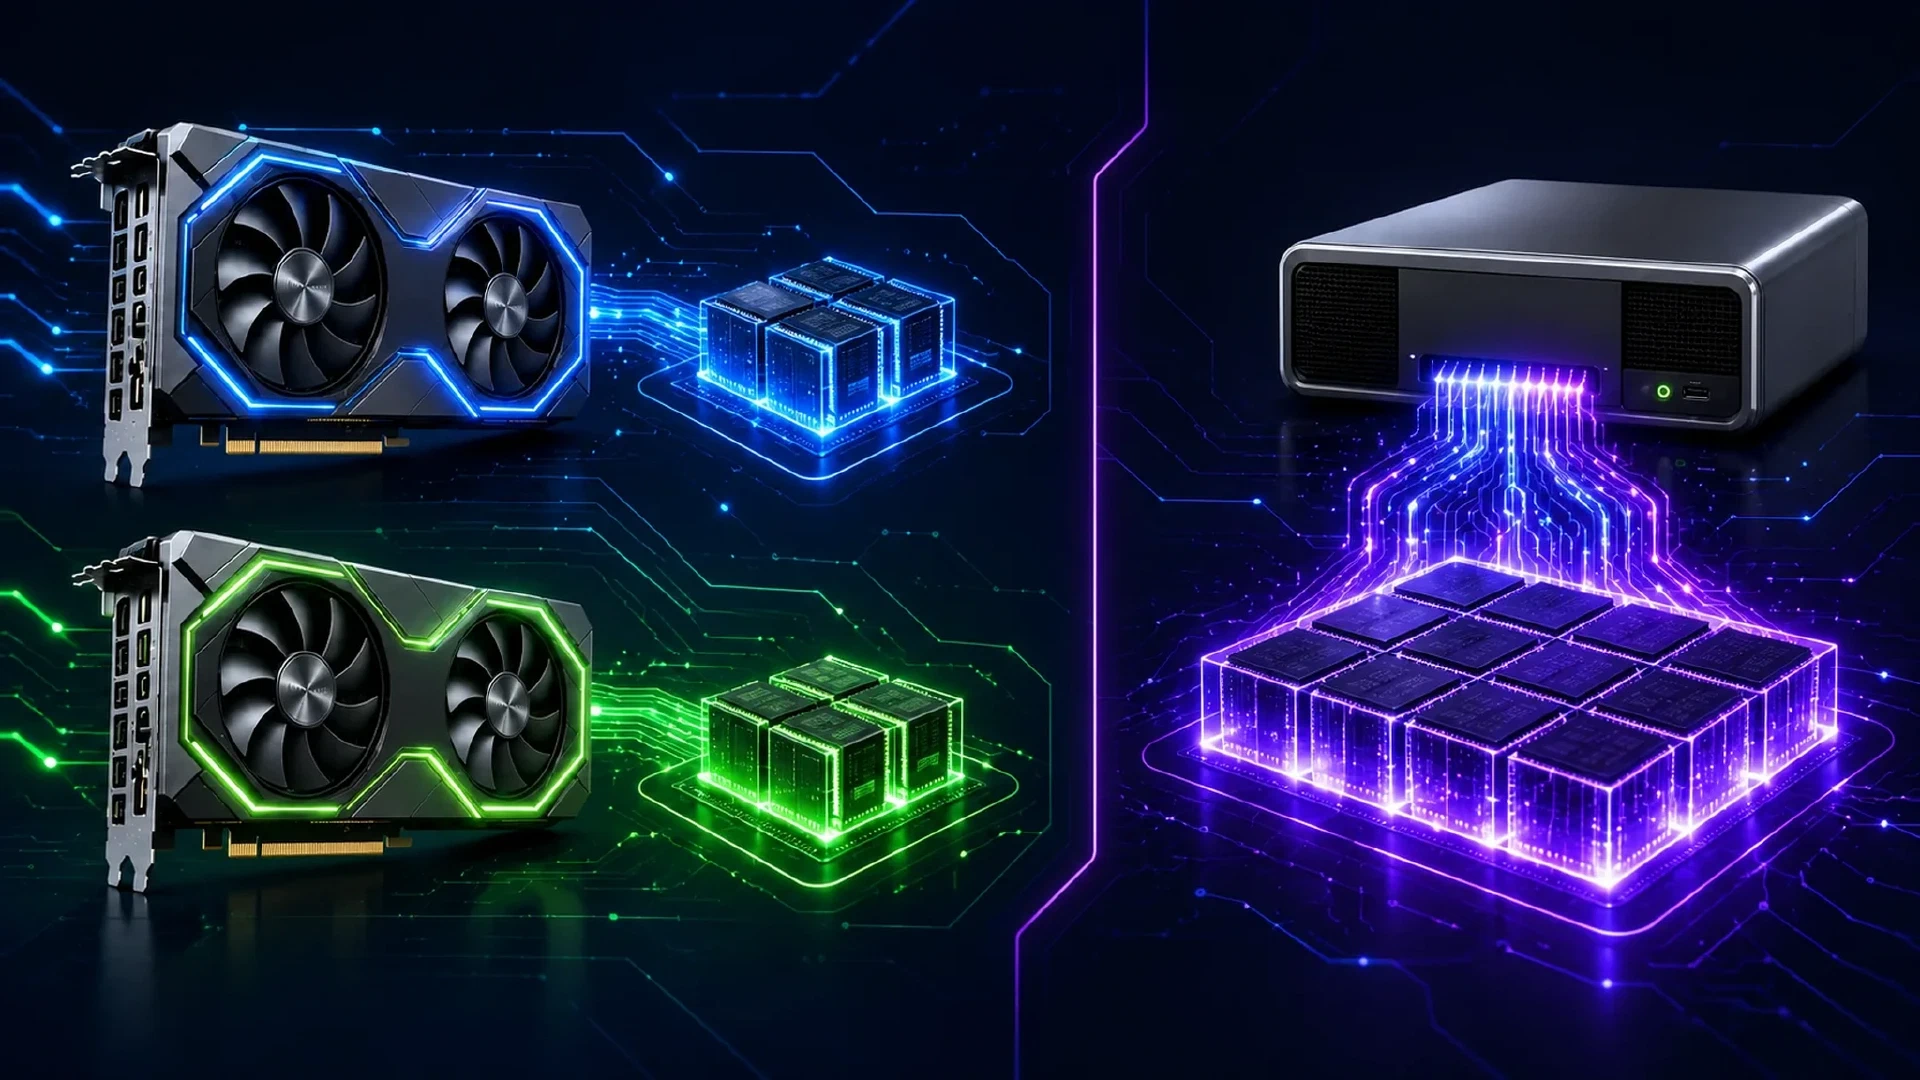
Table of Contents
Deux cartes RTX 5060 Ti de 16 Go semblent attrayantes sur une liste de composants. Elles offrent 32 Go de VRAM cumulée et un traitement rapide des prompts à court contexte. La comparaison change lorsque vous exécutez un modèle 27B avec un long contexte.
Le système NVIDIA GB10 utilise 128 Go de mémoire unifiée cohérente. NVIDIA indique pour la plateforme GB10 128 Go de mémoire unifiée LPDDR5x et un TDP de puce de 140 W. La RTX 5060 Ti utilise 16 Go de GDDR7 par carte, une interface mémoire de 128 bits et une puissance graphique totale de 180 W. Les spécifications de la NVIDIA RTX 5060 Ti et les spécifications du NVIDIA GB10 montrent clairement la différence matérielle.
Le point est simple. Deux cartes de 16 Go ne forment pas un seul pool mémoire rapide de 32 Go. Elles forment deux pools séparés de 16 Go reliés par le système hôte. Pour l’inférence de grands modèles, la capacité manquante et les transferts entre appareils comptent davantage que le nombre de cartes.
Comparaison de la mémoire
| Système | Mémoire | Modèle mémoire | Puissance indiquée |
|---|---|---|---|
| 2x RTX 5060 Ti 16 Go | 32 Go cumulés | Deux pools mémoire GPU séparés | 360 W GPU au total |
| Système GB10 | 128 Go | Mémoire système unifiée cohérente | TDP GB10 de 140 W |
Le GB10 ne gagne pas parce que ses 128 Go de LPDDR5x égalent la bande passante d’un GPU discret haut de gamme. Son avantage vient de la capacité et du placement. Le CPU et le GPU partagent le même espace d’adressage. Le modèle, les tampons d’exécution, les activations et les données de contexte n’ont donc pas à tenir dans deux appareils isolés de 16 Go.
Le système à deux cartes rencontre un problème de placement plus difficile. Le modèle doit tenir sur les deux cartes. Le moteur d’inférence doit déplacer les données entre elles. Le trafic PCIe ajoute de la latence et consomme de la bande passante. La RTX 5060 Ti ne prend pas non plus en charge NVLink, selon les spécifications de NVIDIA.
Résultat du benchmark
Les résultats suivants viennent du rapport de benchmark IA fourni. Le rapport compare un système double GPU sans nom, appelé 5060ti-x2, à un système GB10. Le test couvre Qwen et GPT-OSS avec plusieurs tailles de contexte.
Les modèles provenaient directement d’Ollama. Le test utilisait les tags par défaut exacts qwen3.8:27b et gpt-oss:latest, sans Modelfile personnalisé ni autre quantification. Le système 5060ti-x2 utilisait PCIe Gen4 x16 et les derniers pilotes NVIDIA Linux disponibles lors du benchmark.
Traitement des prompts et génération avec Qwen
| Contexte | Prompt 5060ti-x2 tok/s | Génération 5060ti-x2 tok/s | Prompt GB10 tok/s | Génération GB10 tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
À 4K, le système à deux cartes génère environ deux fois plus vite que le GB10. À 64K, l’avance tombe à environ 1,5 fois. À 128K, les deux systèmes atteignent une vitesse de génération à peu près identique.
À 256K, la comparaison ne ressemble plus à une victoire de la configuration à deux cartes. La requête 5060ti-x2 n’a atteint que 171 359 tokens de prompt réels. La génération est tombée à 1,2 token par seconde. Le GB10 a terminé le test complet de 256K à 25,8 tokens par seconde.
Le GB10 a généré environ 21,5 fois plus vite dans le résultat testé à 256K. Plus important encore, le GB10 a terminé le contexte demandé. Le système à deux cartes n’a pas fourni la même charge de travail.
Pourquoi la VRAM cumulée induit en erreur
1. Le modèle ne voit pas une carte de 32 Go
Deux GPU ne fusionnent pas leur mémoire dans un espace d’adressage local unique. Un moteur parallèle au niveau du modèle répartit les couches ou les tenseurs entre les appareils. Chaque appareil doit garder de la place pour ses poids, ses tampons temporaires et une partie de l’état du contexte.
La capacité utilisable est donc inférieure à la somme simple. L’overhead exact dépend du format du modèle, de la quantification, du backend d’inférence, de la division des tenseurs et de la longueur du contexte.
2. La mémoire du contexte augmente pendant la génération
Les poids du modèle ne représentent qu’une partie du budget mémoire. Le cache clé-valeur, ou cache KV, conserve les données d’attention des tokens précédents. Les contextes plus longs demandent davantage de mémoire de cache. Un test à 4K ne prédit pas un déploiement à 128K ou 256K.
Les résultats fournis montrent clairement cette limite. Le système à deux cartes garde une forte avance pour le traitement des prompts, puis perd en génération lorsque le contexte grandit. Le GB10 reste proche de 26 à 29 tokens générés par seconde de 4K à 256K.
3. Les transferts PCIe ajoutent un coût
Lorsque le moteur déplace des activations ou des tenseurs entre les GPU, le transfert passe par l’interconnexion hôte. Chaque étape reçoit ainsi des points de synchronisation et de la latence supplémentaire. La pénalité augmente lorsque la charge traverse souvent la limite entre appareils.
Cela ne rend pas un système double GPU inutile. Le placement de la mémoire fait partie du résultat de performance. Un benchmark qui ne mesure que le traitement des prompts à 4K ignore ce coût.
4. L’efficacité énergétique est un avantage au niveau du système
Dans cette comparaison, le GB10 consomme moins tout en offrant davantage de capacité mémoire pour la charge à long contexte testée. Deux RTX 5060 Ti représentent ensemble 360 W de puissance GPU avant la consommation du reste du système. NVIDIA indique un TDP de 140 W pour le GB10.
Le GB10 échange la vitesse maximale à court contexte contre la capacité, l’achèvement des requêtes et une puissance GPU plus faible. Ces compromis comptent pour l’inférence Qwen à long contexte.
Le système 5060ti-x2 coûte beaucoup moins cher
La comparaison des performances n’efface pas l’écart de prix. Une station de travail complète avec deux RTX 5060 Ti de 16 Go était affichée à 3 479 $ le 10 octobre 2026. La configuration comprend un Intel Ultra 7 265K, une carte mère Z890, 32 Go de DDR5, 1 To de stockage, une alimentation de 1 000 W et les deux GPU. Voir la station de travail complète à deux GPU .
La marketplace américaine de NVIDIA affiche le DGX Spark de 128 Go à 6 950 $. L’offre comprend 128 Go de mémoire unifiée cohérente et 4 To de stockage NVMe, mais indique que le système est en rupture de stock. Consulter l’offre actuelle du DGX Spark de NVIDIA .
La plateforme AMD Ryzen AI Halo Developer fournit un autre point de comparaison. Ce système Strix Halo est affiché à 3 999,99 $ chez Micro Center, avec 128 Go de mémoire unifiée LPDDR5x et 2 To de stockage. Strix Halo se situe souvent dans la même catégorie pratique d’IA locale que les systèmes GB10, bien que des tests indépendants mesurent souvent le GB10 devant en débit et en maturité logicielle. Consulter l’offre Linux actuelle de Micro Center et lire le test Strix Halo contre GB10 .
| Système complet | Prix affiché le 10 octobre 2026 | Écart de prix |
|---|---|---|
| Station 5060ti-x2 | $3,479 | Référence |
| AMD Ryzen AI Halo, Strix Halo | $3,999.99 | $520.99 de plus |
| DGX Spark GB10 de 128 Go | $6,950 | $3,471 de plus |
Le GB10 fournit un pool de mémoire unifiée plus grand, une consommation plus faible et une meilleure architecture pour les longs contextes. Le système AMD fournit la même classe de mémoire de 128 Go pour environ 4 000 $. La station 5060ti-x2 reste à environ 50 % du prix affiché du GB10, avant taxes et livraison. Les acheteurs qui ont besoin de mémoire unifiée sans la pile logicielle NVIDIA disposent d’une option moins chère avec Strix Halo.
Ces prix proviennent de vendeurs différents et ne constituent pas un panier de vente au détail contrôlé. La comparaison laisse aussi au système 5060ti-x2 moins de mémoire système et de stockage. L’écart reste important, car les deux offres décrivent des ordinateurs complets et utilisables, pas seulement des prix de GPU. Les cartes RTX 5060 Ti de 16 Go sont actuellement affichées autour de 789 à 830 $ chacune, bien au-dessus du prix de lancement de 429 $. L’avantage de prix du système à deux cartes subsiste donc pendant la hausse actuelle des prix des GPU. Consulter les prix actuels de la RTX 5060 Ti .
Le résultat GPT-OSS doit être traité séparément
Le même rapport montre de bons résultats de génération du 5060ti-x2 avec GPT-OSS de 4K à 256K. Le GB10 termine les tests de 4K à 128K, mais le test GPT-OSS à 256K est marqué comme non pris en charge.
N’utilisez pas le tableau GPT-OSS pour annoncer un gagnant universel. Les tests ne couvrent pas la même plage à 256K. Le résultat Qwen donne une comparaison plus nette du long contexte, car les deux systèmes indiquent un résultat à 256K, même si l’exécution 5060ti-x2 n’a atteint que 171 359 tokens de prompt réels.
Ce que cela signifie pour une configuration Qwen 3 27B
Une configuration à deux cartes de 16 Go peut exécuter un modèle 27B quantifié avec un contexte plus court. Le benchmark ne réfute pas ce cas d’usage. Les données réfutent l’affirmation selon laquelle 32 Go de VRAM cumulée offrent la même marge pratique qu’un système à 128 Go de mémoire unifiée.
Faire tenir un modèle sur une carte prouve seulement la capacité pour les poids. Le besoin mémoire réel comprend les poids, le contexte actif, le cache KV, les tampons d’exécution et la marge du système d’exploitation. Le contexte doit tenir à côté du modèle. Un modèle qui se charge mais ne laisse pas de place à la conversation active ne fournit pas une configuration utilisable à long contexte.
Cela correspond aux conseils de dimensionnement de 16 Go de VRAM suffisent-ils pour un travail sérieux avec un LLM local ? , qui traitent les poids, le contexte et les allocations d’exécution comme un seul budget. Le guide des 32 Go de VRAM pour Qwen 27B arrive à la même conclusion pour les configurations à deux cartes. La capacité cumulée n’est pas une marge utilisable équivalente.
Avant d’acheter du matériel pour un déploiement Qwen 3 27B, posez quatre questions :
- La quantification demandée tient-elle avec les tampons d’exécution ? Les poids seuls ne définissent pas le besoin mémoire.
- Le contexte tient-il sans forte pression sur le cache KV ? Les longs prompts changent le résultat.
- Le moteur utilise-t-il une division rapide entre appareils ? Les transferts PCIe et le placement des tenseurs influencent chaque token généré.
- Le système termine-t-il le contexte cible ? Un résultat rapide à 4K ne compense pas une charge de travail 256K échouée.
Le test fourni répond à la dernière question pour le système à deux cartes. L’exécution a atteint 171 359 tokens pendant la requête Qwen à 256K et généré 1,2 token par seconde. Le GB10 a terminé 256K à 25,8 tokens par seconde.
Pour cette charge à long contexte, la mémoire unifiée offre une meilleure architecture lorsque l’alternative s’appuie sur PCIe pour couvrir l’ensemble de travail du modèle. PCIe reste une solution de capacité. PCIe ne crée ni le même pool mémoire, ni la même latence, ni le même chemin de transfert. Le guide du contexte GPU pour l’IA locale explique pourquoi les poids, le cache KV, la sortie des outils et les tampons d’exécution doivent être dimensionnés ensemble. Le benchmark GPU Qwen3.8 27B avec Ollama montre aussi pourquoi les résultats à long contexte doivent être examinés séparément des chiffres de décodage à court contexte.
Verdict
Deux cartes RTX 5060 Ti de 16 Go remplacent mal un GB10 lorsque l’objectif est l’inférence 27B à long contexte. Elles offrent un meilleur débit de prompts aux petites tailles de contexte. Elles consomment aussi davantage de puissance GPU et exposent le moteur à une organisation mémoire répartie.
Le GB10 traite les prompts plus lentement dans les résultats fournis. Le système est plus efficace énergétiquement, offre quatre fois la mémoire cumulée et termine le test Qwen complet à 256K avec une vitesse de génération utilisable.
Si vous utilisez des prompts courts et donnez la priorité à leur ingestion, 5060ti-x2 a un cas d’usage limité. Pour un modèle 27B, le pool de mémoire unifiée plus grand est le meilleur choix, car le modèle et son contexte partagent un espace de travail cohérent. La mémoire unifiée reste préférable dès que les transferts PCIe entrent dans le chemin d’inférence.
Le benchmark ne montre pas que deux RTX 5060 Ti ne démarreront jamais Qwen 3 27B. Les données montrent pourquoi démarrer le modèle diffère d’une exécution efficace de la charge de travail.
Limites du benchmark
Le rapport fourni indique les tags Ollama exacts, mais ne donne pas les condensats des manifestes résolus, les versions des modèles, le CPU, les mesures de puissance ni la configuration de refroidissement. Il indique aussi PCIe Gen4 x16 pour le système 5060ti-x2 et les pilotes NVIDIA Linux disponibles lors du test. Traitez ces chiffres comme une comparaison de systèmes observée, pas comme un classement universel de chaque paire de RTX 5060 Ti et de chaque implémentation GB10.
Les spécifications matérielles ci-dessus viennent de NVIDIA. Les performances viennent des données de benchmark fournies pour cet article.
Références
- Bibliothèque de modèles Ollama Qwen3.8
- Tags de modèles Ollama GPT-OSS
- 16 Go de VRAM suffisent-ils pour un travail sérieux avec un LLM local ?
- 32 Go de VRAM pour Qwen 27B
- Guide du contexte GPU pour l’IA locale
- Benchmarks GPU Qwen3.8 27B sur Vast.ai
- Station de travail complète avec deux RTX 5060 Ti de 16 Go
- Offre NVIDIA DGX Spark sur la marketplace américaine
- Offre Linux AMD Ryzen AI Halo de 128 Go
- Test Tom’s Hardware de Strix Halo contre GB10
- Prix actuels de la RTX 5060 Ti
Related Posts