
Au cœur de notre flotte hybride d’agents IA : Hermes, LiteLLM et Tailscale

Table of Contents
Nous avons déployé une flotte GPU locale affectée par requête et conçu son plan de contrôle hybride. Le parcours vérifié commence dans LiteLLM, sélectionne un groupe de modèles et charge un modèle local sur un seul GPU à la fois. La politique de niveaux Hermes est proposée, et un artefact de configuration Tailscale Aperture est prêt pour le prochain test d’intégration. Aucun des deux n’a été vérifié dans un parcours complet de bout en bout.
Les cartes inactives minent Pearl. Une requête d’IA suspend le minage uniquement sur la carte louée, traite la requête, décharge le modèle, puis rend la carte au mineur.
Points essentiels
- T0 à T2 prennent en charge les tâches coûteuses ou exigeantes. Ces parcours privilégient les modèles hébergés de pointe et des chaînes de repli ordonnées.
- T3 gère les tâches locales substantielles. La flotte attribue la planification, le codage, la revue et la vision à des modèles de 4B à 12B.
- T4 gère les tâches locales fréquentes. De petits modèles routent, classent, extraient, produisent des embeddings et accomplissent des tâches de code délimitées.
- Chaque GPU est une ressource indépendante. Une carte sert l’IA pendant que les autres continuent de miner.
- Les modèles locaux restent déchargés au repos. Aucun modèle ne conserve de mémoire GPU entre les périodes de requêtes.
- Toutes les passerelles exposent le même catalogue logique. Les alias partagés répartissent le travail entre les systèmes admissibles. Les alias préfixés par un nœud conservent un placement précis si nécessaire.
- Le broker expérimental n’a pas été mis en production. Son test canari a servi une requête, puis échoué au test d’arrêt propre. LiteLLM est resté sur le parcours vérifié à l’échelle d’une requête.
- Hermes et Aperture restent en préparation. La conception cible existe, mais le test d’acceptation de bout en bout reste à faire.
Prérequis : plusieurs hôtes Linux avec GPU, des pilotes NVIDIA stables, un tailnet Tailscale, systemd, un mineur fonctionnel, du stockage pour les modèles et des tests d’acceptation pour chaque parcours de modèle.
Durée et difficulté : avancé. Prévoyez plusieurs jours pour l’inventaire, le téléchargement des modèles, les définitions de services, les tests de routage, les exercices de panne et les contrôles de reprise du minage pour chaque carte.
Termes utilisés ci-dessous : un tailnet est le réseau privé formé par les identités et appareils Tailscale. Un alias de modèle est un nom de modèle stable présenté aux clients. Un groupe de modèles place plusieurs déploiements derrière un alias. Un proxy de pool est un petit service local qui loue un GPU, démarre le worker du modèle et rend la carte au minage.
Objectif de conception
Les tâches agentiques prennent de nombreuses formes. La réparation d’un dépôt nécessite un modèle différent de celui qui convient à un titre, une capture d’écran, un embedding ou une étiquette d’intention. Envoyer chaque tour au plus grand modèle gaspille de l’argent et de la capacité locale. Envoyer chaque tour au plus petit modèle entraîne des reprises et des résultats médiocres.
Nous voulions un seul catalogue couvrant cinq niveaux de charge. La politique devait servir des modèles hébergés et locaux par l’intermédiaire de formats d’API courants. Les GPU locaux devaient rester productifs entre les requêtes d’IA.
La flotte devait aussi gérer la concurrence. Un hôte doté de plusieurs cartes devait servir plusieurs tâches indépendantes en parallèle. Une requête sur une carte ne devait pas arrêter le minage sur toutes les cartes du châssis.
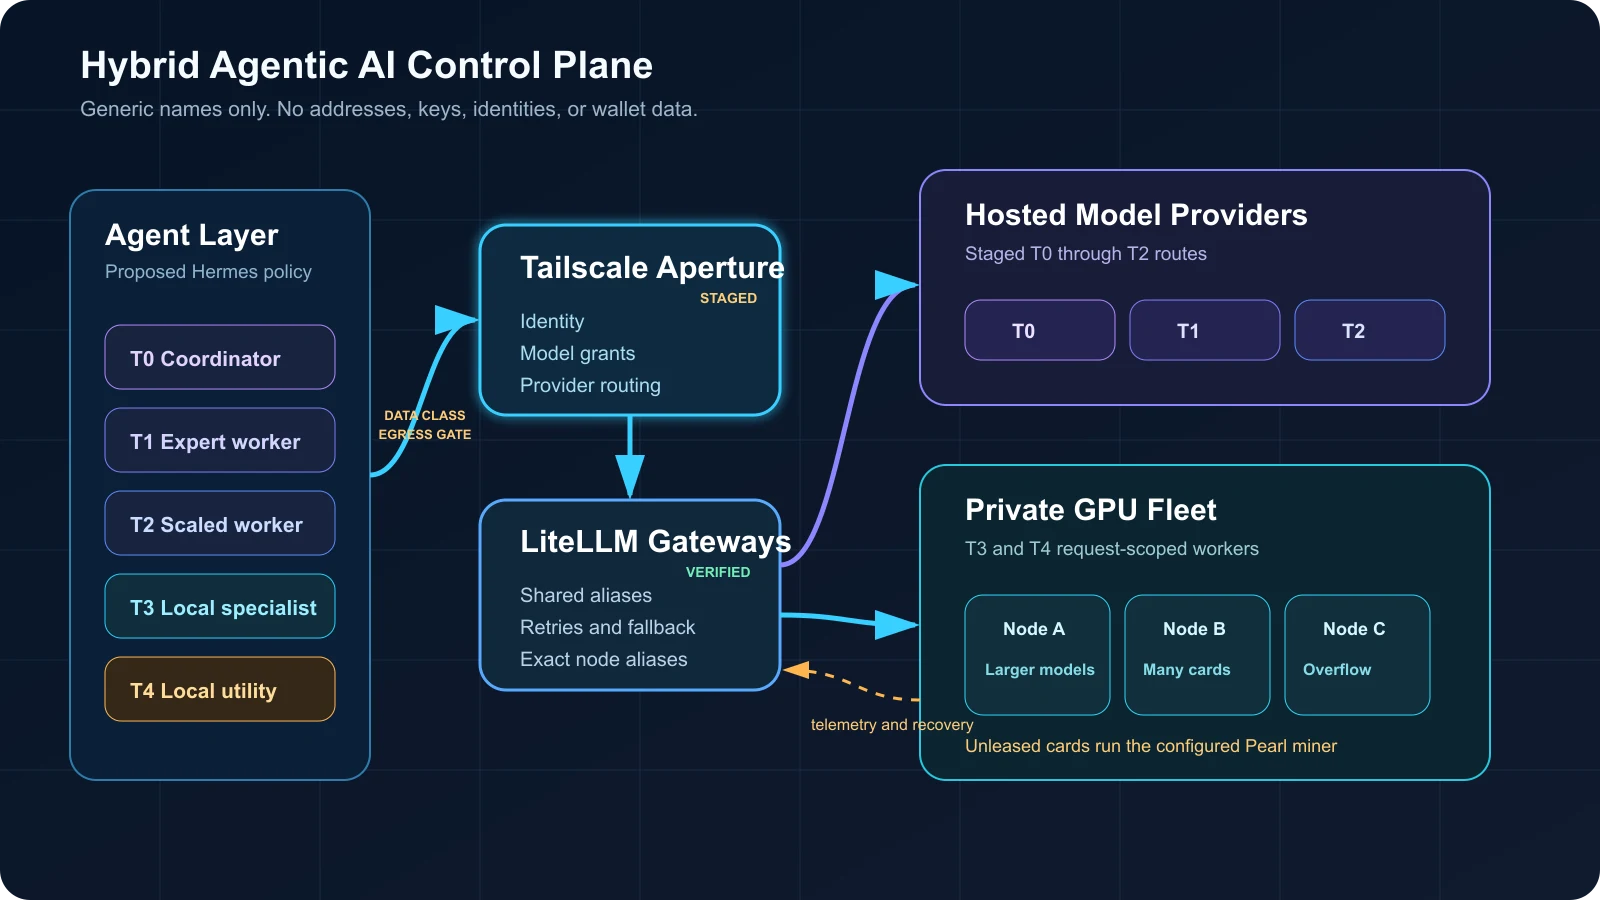
Le plan de contrôle proposé et en préparation se situe au-dessus du parcours d’exécution vérifié de LiteLLM et par GPU
Le schéma utilise des noms de nœuds génériques. Il omet les adresses privées, les identités des utilisateurs, les clés d’accès, les données de portefeuille et les étiquettes des hôtes physiques.
Signification de T0 à T4
Les noms de niveaux définissent notre politique de routage. Ce n’est pas une norme du secteur et ils ne décrivent pas uniquement la taille du modèle.
| Niveau | Rôle principal | Destination habituelle | Comportement en cas de panne |
|---|---|---|---|
| T0 | Coordinateur par défaut et décisions les plus difficiles | Modèle de raisonnement hébergé de pointe | Chaîne de repli hébergée ordonnée |
| T1 | Agents workers à forte valeur | Pool hébergé de modèles puissants | Nouvelle tentative dans la chaîne attribuée |
| T2 | Pool général de workers | Modèles hébergés rapides, avec escalade | Escalade des tâches difficiles vers T1 ou T0 |
| T3 | Travail local privé substantiel | Modèles locaux de discussion, code, revue et vision de 4B à 12B | Nouvelle tentative sur un nœud local admissible, puis échec fermé pour les données restreintes |
| T4 | Travail local ciblé et fréquent | Modèles locaux de routage, classification, code et embeddings de 0,6B à 3B | Nouvelle tentative sur une réplique locale ou passage à T3 dans la même frontière de données |
Les niveaux décrivent d’abord la tâche, puis le modèle. Une classification courte et sensible pour la sécurité convient à T4. Un long plan de dépôt convient à T3 ou à un niveau supérieur. Une décision architecturale difficile commence à un niveau supérieur, même si son invite est courte.
Cette répartition change aussi l’économie des agents. Les workers T4 absorbent les transformations répétitives à faible risque. Les workers T3 gardent le code courant et l’analyse dans le tailnet. T0 à T2 restent disponibles pour les tâches difficiles et la reprise après panne.
Un filtre selon la catégorie des données doit précéder tout repli hébergé. Les tâches publiques, internes et restreintes reçoivent des chaînes distinctes. Les tâches restreintes restent locales et échouent en mode fermé. Une nouvelle tentative qui franchit une frontière exige des entrées assainies ainsi que l’approbation explicite de l’utilisateur ou du workflow. La suppression des données sensibles retire les identifiants, secrets du dépôt, sorties privées des outils et contenus sensibles récupérés avant tout appel hébergé.
Hermes définira la politique des tâches
Hermes est la couche d’agents proposée. La politique cible attribue une catégorie de modèle, exécute des outils, délègue le travail et parcourt des chaînes de repli explicites. Hermes documente des parcours distincts pour le modèle principal, les tâches auxiliaires, les agents délégués et les replis propres à une tâche. Il prend aussi en charge des points de terminaison personnalisés compatibles OpenAI via une URL de base. Consultez le guide de configuration Hermes et le guide des fournisseurs de repli .
Notre politique associe les tâches Hermes à des alias stables plutôt qu’à des serveurs physiques. Exemples :
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
L’alias exprime l’intention. Hermes n’a pas besoin de savoir quel GPU est libre, quel nœud possède une carte plus grande, ni quelle réplique a échoué au contrôle de santé. Les couches inférieures prennent ces décisions.
Certaines tâches nécessitent encore un placement déterministe. Un identifiant de modèle préfixé par un nœud envoie un diagnostic opérateur ou un benchmark à un système choisi. Des autorisations Aperture distinctes devraient réserver ces alias aux opérateurs. Le trafic normal des agents utilise les alias de niveau partagés.
L’accès aux modèles ne sécurise pas les outils des agents. Le déploiement Hermes nécessite des listes d’autorisation d’outils au moindre privilège, des espaces de travail isolés, des identifiants limités, des contrôles du trafic réseau sortant et un traitement des injections de prompt. Les workers délégués ne devraient hériter que des accès nécessaires à la tâche attribuée.
Aperture constitue la frontière d’identité en préparation
Tailscale relie la passerelle configurée et les hôtes d’inférence sans exposer chaque service à l’Internet public. Aperture est préparé comme frontière destinée aux utilisateurs et comme routeur de modèles. Ce parcours nécessite encore un test d’acceptation de bout en bout. Tailscale décrit l’accès client chiffré sur le tailnet et le transfert des fournisseurs via TLS dans Fonctionnement d’Aperture .
Aperture sépare aussi l’accessibilité de l’autorisation. Ses autorisations refusent l’accès par défaut. Après avoir atteint la passerelle, un utilisateur ou un appareil étiqueté a besoin d’une autorisation de modèle correspondante. Le guide des autorisations Aperture explique le modèle d’autorisations cumulatives et les sources d’identité.
Avant le déploiement, la configuration Aperture en préparation doit suivre quatre règles :
- Une seule identité nommée détient le rôle d’administrateur. L’accès général aux modèles n’accorde pas de droits d’administration.
- Les fournisseurs répertorient des identifiants de modèles explicites. Aperture ne déduit pas les modèles depuis un service amont.
- Les URL des fournisseurs pointent vers des adresses du tailnet. Les noms et adresses des nœuds privés restent absents de l’article et des exemples de configuration publics.
- Les secrets restent dans des fichiers appartenant au service. Avant le déploiement, appliquez des permissions réservées au propriétaire, des comptes de service restreints, une rotation et la suppression des données sensibles des journaux. Les sorties de diagnostic ne doivent jamais afficher de clés LiteLLM, d’adresses du tailnet, de jetons d’abonnement ni de données de portefeuille.
Aperture ajoute le chemin de requête entrant à l’URL de base de chaque fournisseur. Sa
référence de configuration
déconseille d’ajouter un suffixe /v1 en double à la racine du fournisseur. Ce détail a créé assez de risque d’intégration pour justifier un contrôle explicite.
La vision est prête à passer par le format OpenAI Chat Completions avec du contenu image. Les embeddings utilisent directement le point de terminaison LiteLLM privé, car la matrice actuelle des fournisseurs auto-hébergés d’Aperture documente les formats de discussion, tandis que notre parcours d’embeddings dépend des points de terminaison LiteLLM et llama.cpp hors du sélecteur de discussion. Consultez la référence des fournisseurs et clients pris en charge .
Le parcours direct des embeddings nécessite sa propre frontière d’autorisation. L’authentification LiteLLM, des autorisations Tailscale restrictives, la liaison du service à l’interface du tailnet et les règles du pare-feu de l’hôte devraient limiter l’accès aux identités ou étiquettes de service approuvées. Une adresse privée ne constitue pas à elle seule une politique d’autorisation.
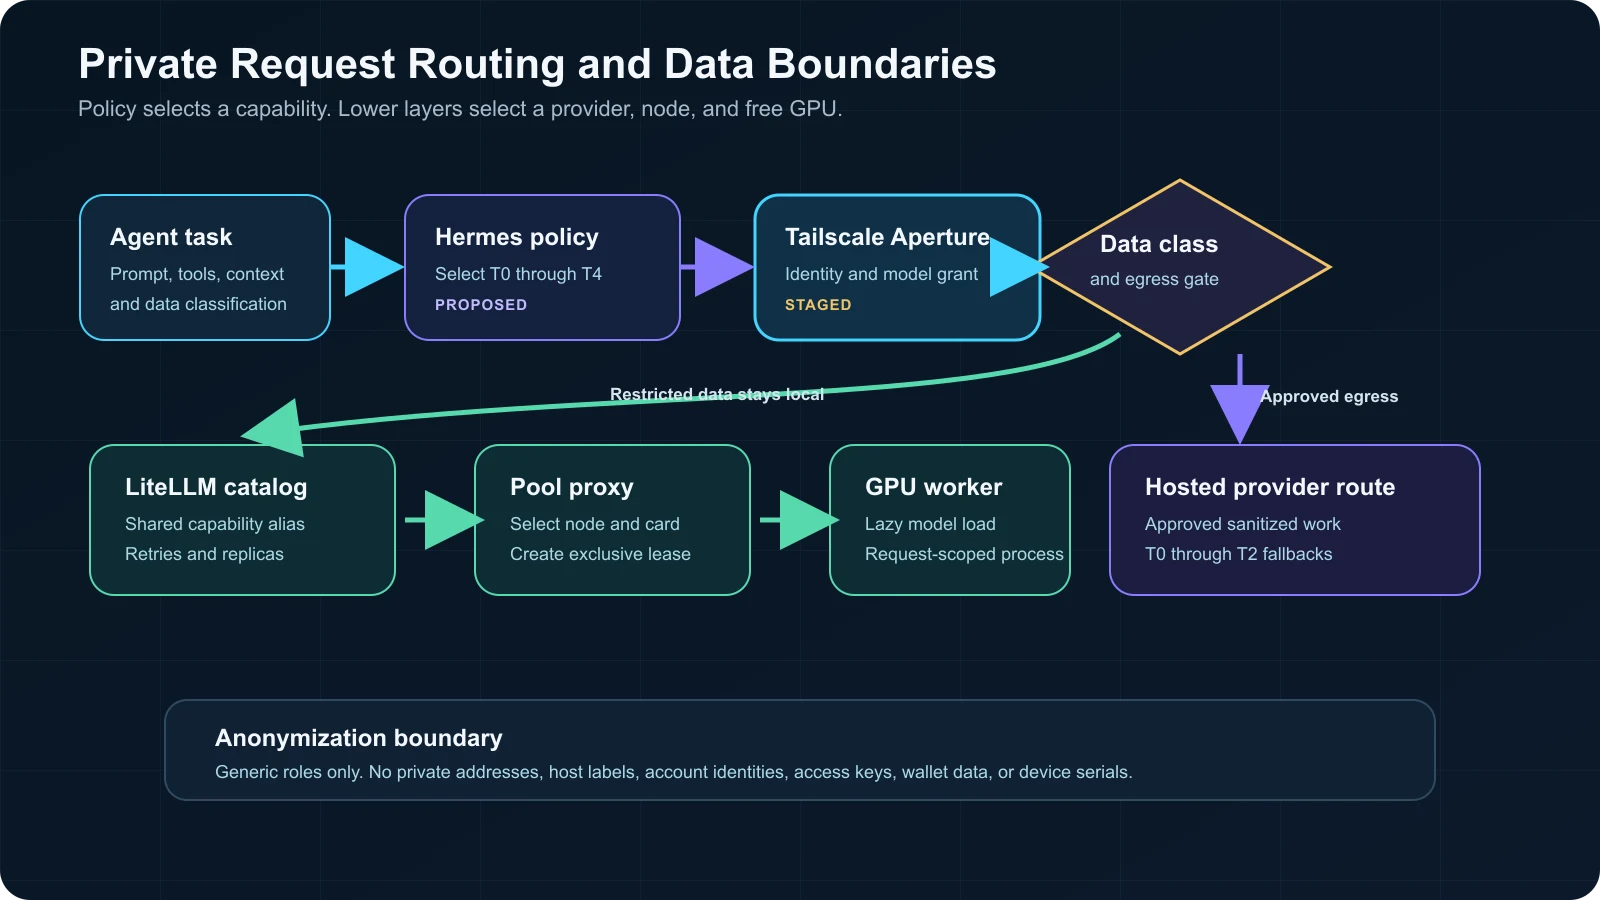
L’identité, les autorisations et la classification des données déterminent si une requête quitte la flotte privée
LiteLLM présente un catalogue unique
Chaque hôte d’inférence exécute une passerelle LiteLLM. Toutes les passerelles exposent le même catalogue logique de modèles, même si un modèle se trouve sur un autre nœud. Le client conserve une seule forme d’API et un seul ensemble d’alias.
LiteLLM regroupe plusieurs déploiements sous un nom de modèle. Son routeur sélectionne ensuite un déploiement admissible et applique les nouvelles tentatives, délais d’attente, périodes de refroidissement ou replis. La documentation actuelle sur le routage LiteLLM décrit les noms de modèles partagés, les stratégies de routage et le comportement des nouvelles tentatives.
Le catalogue possède deux styles d’adresses :
| Style d’adresse | Exemple | Utilisation |
|---|---|---|
| Alias partagé | t4-classify | Répartir le travail normal entre les nœuds admissibles |
| Alias de nœud | node-b/qwen-small | Lancer des diagnostics ou conserver un placement précis |
Les alias partagés assurent une montée en charge horizontale sans modifier Hermes. L’ajout d’une réplique admissible étend le groupe de modèles. Le retrait d’une réplique en mauvais état le réduit.
La gestion du cycle de vie des GPU reste sous LiteLLM. La passerelle reste active, car son empreinte mémoire ne réserve pas de mémoire GPU. Un proxy local de pool reçoit la requête du modèle sélectionné, loue une carte, démarre le worker et l’arrête après la réponse.
Catalogue local de modèles
La flotte privilégie les modèles de 12B paramètres ou moins. Cette limite correspond à la mémoire des cartes disponibles tout en laissant de la place au contexte et aux tampons d’exécution.
Notation des modèles : B désigne des milliards de paramètres. K désigne des milliers de jetons de contexte configurés. La quantification stocke les poids du modèle avec une précision numérique réduite pour diminuer la mémoire nécessaire. Le cache KV conserve l’état d’attention du contexte actif et augmente avec la longueur de l’invite. E4B est la désignation de Google pour la variante Gemma 4 plus petite.
| Parcours de niveau | Catégorie de modèle | Contexte configuré | Tâche principale | Placement |
|---|---|---|---|---|
| T3 intelligent | Qwen3.5 9B, quantifié | 64K | Planification locale difficile et travail général d’agent | Nœuds GPU à mémoire supérieure |
| Code T3 | Granite 4.2 8B, quantifié | 64K | Travail sur les dépôts, outils, terminal, sorties structurées | Nœuds GPU à mémoire supérieure |
| Revue T3 | Gemma 4 12B, quantifié | 32K | Revue indépendante et raisonnement alternatif | Nœuds GPU à mémoire supérieure |
| Général et vision T3 | Qwen3.5 4B, quantifié | 32K | Travail général à l’échelle et compréhension d’images | Tous les GPU compatibles |
| Revue alternative T3 | Gemma 4 E4B, quantifié | 8K | Parcours de revue diversifié | Tous les GPU compatibles |
| Code T4 | Granite 4.2 3B, quantifié | 16K | Petites modifications, appels d’outils, sorties structurées | Tous les GPU compatibles |
| Classification T4 | Qwen3.5 2B, quantifié | 16K | Classification, extraction et réécriture | Tous les GPU compatibles |
| Routeur T4 | Qwen3.5 0.8B, quantification haute précision | 16K | Intentions, étiquettes, titres et transformations courtes | Tous les GPU compatibles |
| Embeddings T4 | Qwen3 Embedding 0.6B, quantifié | 32K | Mémoire d’agent, RAG, recherche de code et regroupement | Tous les GPU compatibles |
Ces valeurs de contexte sont des paramètres de déploiement, pas les limites annoncées des modèles. Une fenêtre annoncée plus grande consomme quand même du cache KV et de la mémoire d’exécution. Nous avons choisi des valeurs plus basses pour assurer un service stable sur une seule carte.
Qwen décrit Qwen3.5 comme une famille multimodale et publie des variantes denses, des petites aux plus grandes, dans la collection Qwen3.5 . IBM publie des résultats de codage agentique et de contexte long pour Granite 4.2 8B . Google indique que Gemma 4 prend en charge les entrées multimodales, les appels de fonction et une fenêtre annoncée plus grande.
Le parcours d’embeddings utilise un modèle distinct au lieu de demander à un modèle de discussion de produire des vecteurs. La fiche du modèle Qwen3 Embedding 0.6B indique une séquence de 32K, la recherche multilingue et de code, ainsi que des dimensions de sortie allant jusqu’à 1 024.
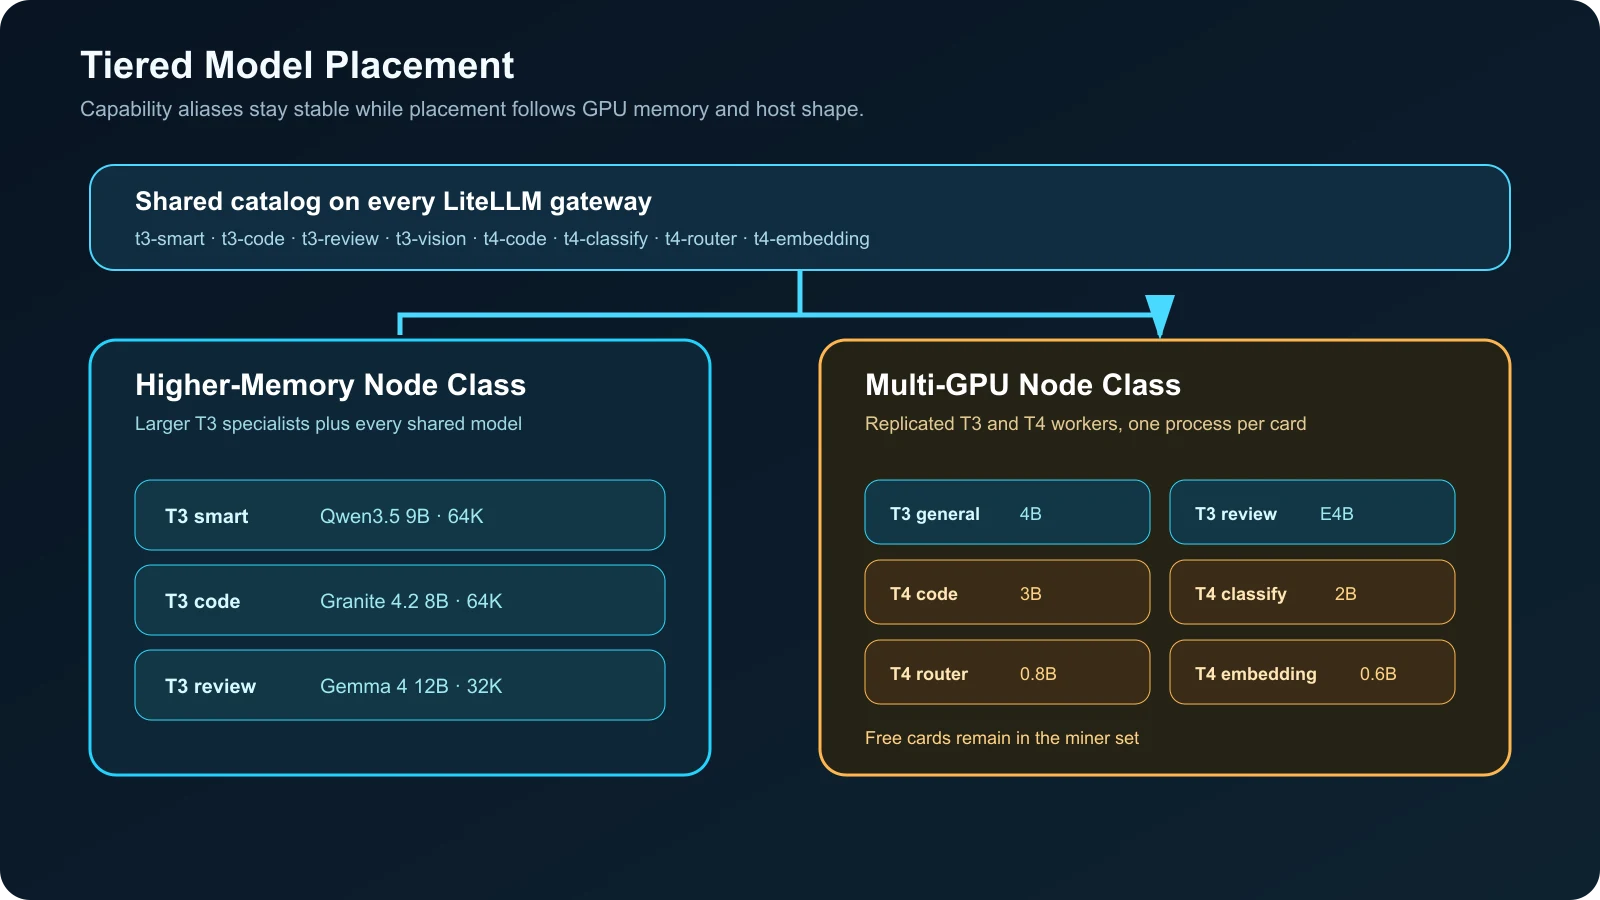
Les spécialistes plus grands restent sur les cartes à mémoire élevée, tandis que les spécialistes plus petits se répliquent dans la flotte
Pourquoi llama.cpp sert la production
llama.cpp correspond au modèle de ressources. Un worker statique correspond à un GPU, un fichier de modèle, un contexte configuré et un bail. La séparation des processus facilite l’audit du démarrage, de l’arrêt, de la visibilité du GPU et des journaux.
Son serveur expose des API de discussion, de réponses et d’embeddings compatibles OpenAI. Il prend aussi en charge le décodage parallèle et le traitement continu par lots. La documentation actuelle du serveur qualifie la prise en charge multimodale d’expérimentale. Ces fonctions figurent dans la documentation du serveur llama.cpp .
Ollama reste disponible comme parcours de compatibilité sur un nœud plus grand. Ollama prend en charge le chargement simultané de modèles lorsque la mémoire le permet et le déchargement immédiat via keep_alive: 0, comme le précise la
FAQ Ollama
. Nous n’avons pas retenu Ollama pour le parcours de production par carte, car les workers statiques llama.cpp nous donnent un contrôle plus précis du placement et de l’arrêt.
Nous avons aussi examiné Strata. Strata vise un grand modèle Qwen à mélange d’experts réparti entre mémoire GPU, RAM système et stockage. Ses préréglages publiés commencent à 32 Go de mémoire combinée, tandis que le mode basse RAM échange de la vitesse contre une capacité réduite. Consultez le dépôt Strata . Strata répond à un autre objectif : exécuter un modèle hybride plus grand sur une ou plusieurs cartes. Notre flotte privilégie de nombreux workers indépendants sous 12B.
Chargement différé par GPU
Le chargement différé s’applique à chaque worker de modèle. Entre les requêtes, le système ne garde actifs que les passerelles, les proxys de pool, les watchdogs et le mineur.
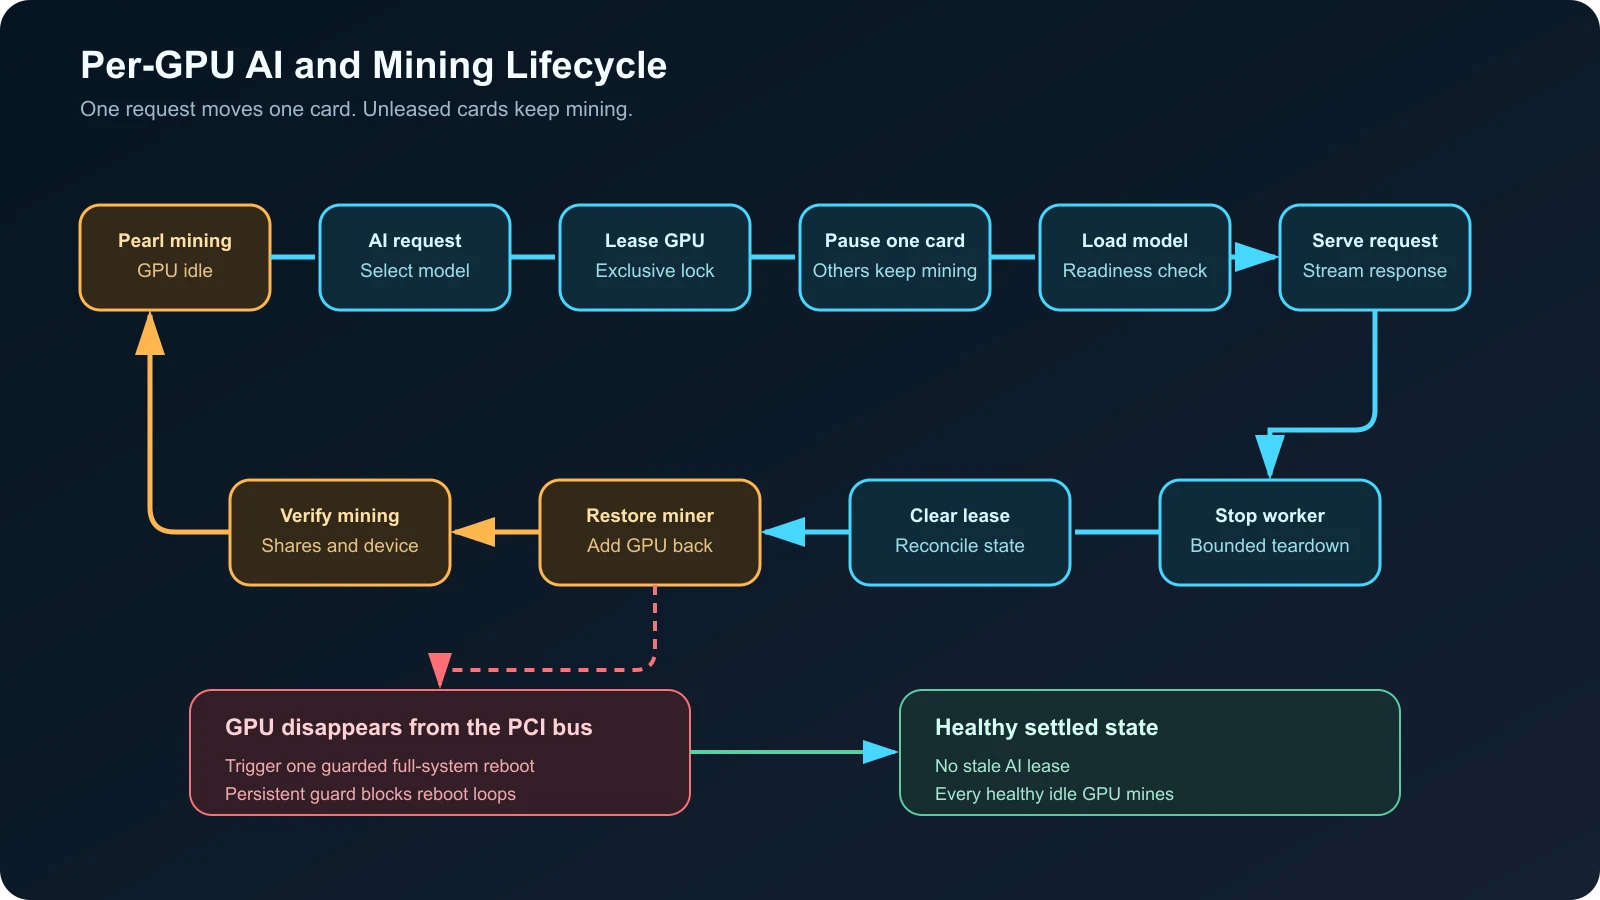
Seule la carte louée quitte le mineur, puis elle y retourne après la fin du processus de modèle
Le cycle de vie d’une requête suit ces étapes :
- LiteLLM sélectionne un déploiement. La requête arrive au proxy de pool correspondant à la catégorie de modèle choisie.
- Le pool acquiert un bail. Un verrou empêche deux workers exclusifs de prendre la même carte.
- Le mineur redémarre sans un GPU. Chaque carte non louée reste dans la commande Pearl.
- llama.cpp démarre sur l’appareil loué. Les contrôles de disponibilité se terminent avant que le proxy transfère la requête.
- Le worker sert la réponse. Les requêtes simultanées démarrent des workers sur d’autres cartes libres.
- Le worker se termine. Le pool supprime le bail après l’arrêt du processus.
- Le mineur redémarre avec le GPU libéré. Les contrôles de santé confirment que la carte a repris le minage.
Cela diffère d’un basculement global de l’hôte. Un châssis de plusieurs cartes sert plusieurs modèles tandis que les autres cartes continuent de miner. Au repos, la flotte rend chaque GPU en bon état à Pearl.
Le livre blanc Pearl décrit son système de preuve par calcul matriciel. Notre architecture ne repose ni sur une prévision de rentabilité ni sur une promesse de rendement économique. Le minage est la charge de travail configurée lorsque les cartes sont inactives.
La gestion des pannes compte plus que le démarrage
Le démarrage du modèle ne couvre que la moitié du cycle de vie. Les arrêts forcés, GPU disparus, requêtes interrompues, baux périmés et redémarrages du mineur nécessitent un traitement explicite.
Notre watchdog compare l’ensemble de GPU configuré à la liste active des appareils NVIDIA. La disparition confirmée d’un GPU déclenche un seul redémarrage complet du système, protégé par des garde-fous. En production, le déclencheur sûr devrait exiger plusieurs contrôles échoués, un délai de refroidissement, l’arrêt des tâches actives, un compteur de redémarrages persistant et une alerte distante. Un seul échec de récupération devrait arrêter l’automatisation et exiger une intervention manuelle.
Le même watchdog réconcilie les baux périmés. Si aucun worker ne détient un bail, la réconciliation supprime l’enregistrement périmé et rend le GPU au mineur. Ce parcours de reprise a compté pendant le test canari du broker.
| Panne | Réponse |
|---|---|
| Le modèle échoue au contrôle de disponibilité | Arrêter le worker, libérer le bail, rétablir le minage et renvoyer une erreur |
| La requête se termine de façon inattendue | Limiter la durée du nettoyage, terminer l’arbre de processus du worker et réconcilier le bail |
| Le GPU disparaît | Confirmer plusieurs absences, arrêter les tâches actives, lancer un redémarrage protégé unique, envoyer une alerte, puis vérifier l’ensemble des GPU configurés |
| Le mineur omet une carte inactive | Reconstruire la liste des appareils à partir des baux actifs et redémarrer le mineur |
| Un déploiement LiteLLM échoue | Réessayer une autre réplique du même groupe de modèles, puis appliquer la politique de repli |
| Une autorisation Aperture bloque un parcours | Corriger l’identité ou l’autorisation du modèle, sans contourner la politique de la passerelle |
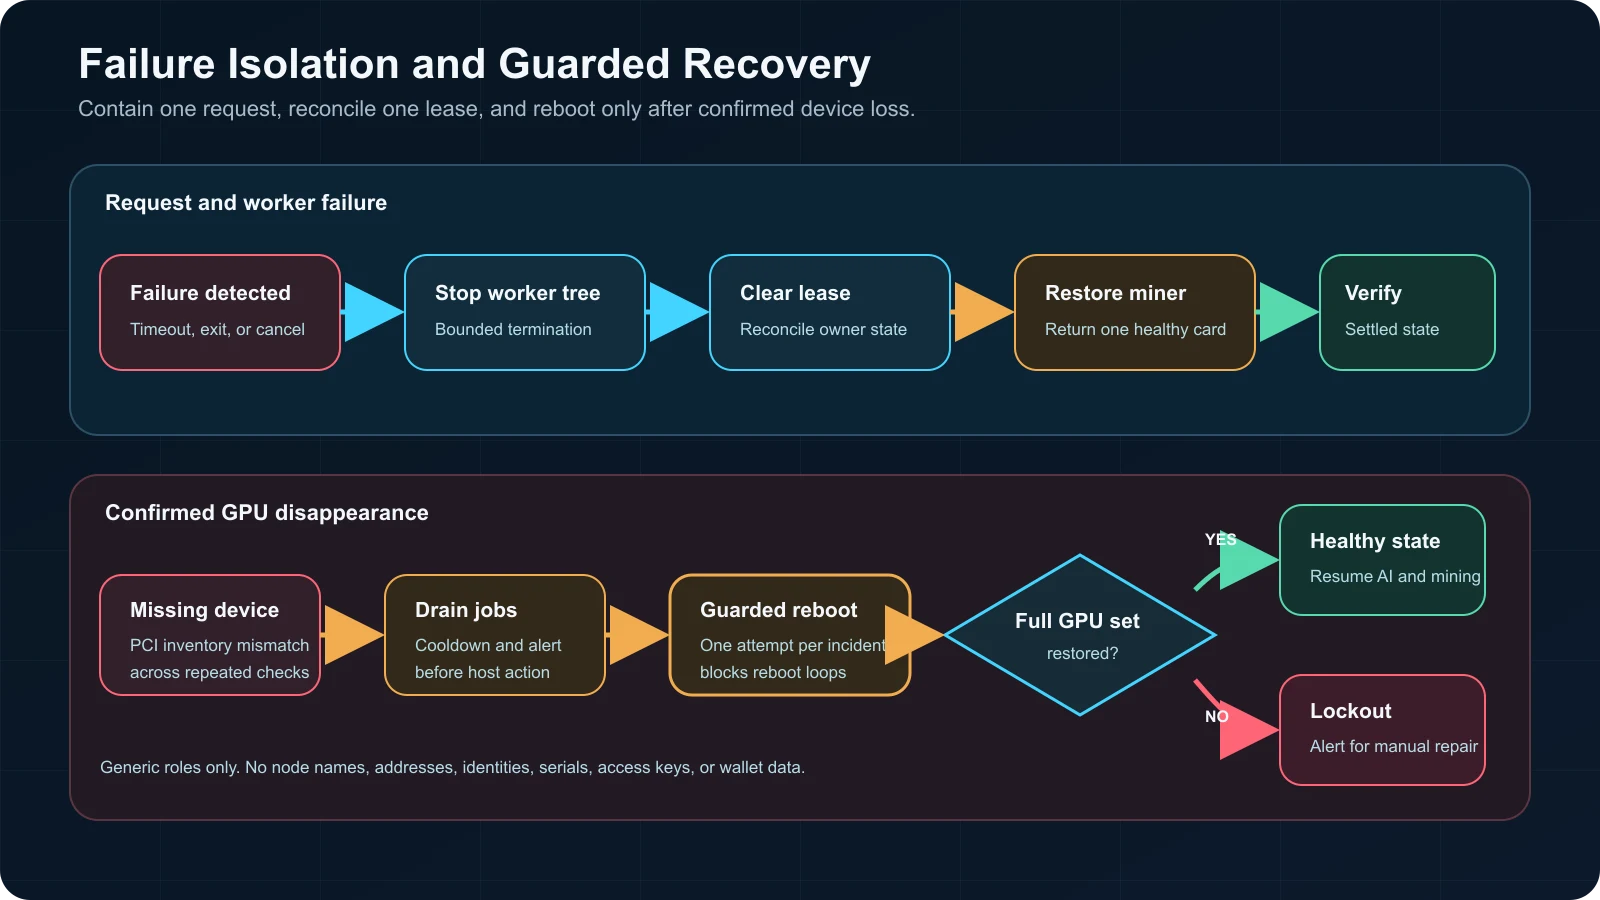
Les pannes courantes libèrent un bail, tandis que la perte confirmée d’un appareil déclenche le parcours de reprise protégé de l’hôte
Résultat du broker expérimental
Le broker agnostique au backend vise à présenter une seule interface compatible OpenAI pour Ollama, vLLM, llama.cpp et Strata. Il inclut la gestion du cycle de vie par modèle, le déchargement au repos et le placement des GPU.
Nous avons testé le broker version 0.6.0 au commit c12b65 le 21 octobre 2026. Sa suite locale a signalé 1 101 tests réussis et 2 ignorés, avec Ruff sans erreur. Le test canari a ensuite chargé un modèle à la demande et servi une requête de discussion réussie. Les autres GPU ont continué de miner pendant la requête.
L’arrêt a révélé un problème critique de cycle de vie. Après le chargement d’un modèle, le broker restait bloqué dans son parcours d’arrêt jusqu’à ce que systemd tue l’arbre de processus. L’arrêt forcé a laissé un bail GPU périmé jusqu’à ce que la réconciliation rétablisse le mineur. Nous avons aussi trouvé un écart entre le paramètre de GPU requis documenté et son application par l’adaptateur de production.
Nous avons désactivé le broker dans le parcours de production. LiteLLM route maintenant par le proxy de pool à l’échelle de la requête. Le broker reste expérimental tant que l’arrêt borné des processus enfants, la terminaison des groupes de processus, les contrôles d’admission des GPU requis et le nettoyage des baux périmés n’ont pas réussi les tests d’intégration.
Ce résultat donne une leçon d’ingénierie utile. Le démarrage ponctuel d’un modèle ne prouve pas grand-chose pour un broker. La préparation à la production dépend d’un arrêt propre, d’une reprise bornée, d’une admission exclusive des appareils et d’exercices de panne reproductibles.
Vérifications effectuées
Le test de déploiement couvrait plus qu’une réponse de modèle :
- Chaque modèle de discussion partagé a terminé le cycle de chargement, réponse, arrêt et reprise Pearl sur au moins un hôte admissible.
- La vision a accepté une entrée image via le parcours de discussion.
- Les embeddings ont renvoyé la taille de vecteur configurée via le parcours LiteLLM privé.
- Plusieurs modèles ont fonctionné simultanément sur des cartes distinctes.
- Les cartes non louées sont restées dans le mineur pendant les requêtes d’IA simultanées.
- Les alias partagés ont routé les requêtes entre les nœuds admissibles.
- Les alias préfixés par un nœud ont conservé un placement déterministe.
- Chaque passerelle LiteLLM a répertorié le même catalogue logique.
- Un GPU manquant a été récupéré après un redémarrage complet de l’hôte. Le watchdog comporte maintenant une protection persistante contre les boucles.
- L’échec d’arrêt du broker a été récupéré par réconciliation du bail.
- L’état final stabilisé ne présentait aucun bail IA et chaque GPU en bon état était de nouveau affecté au minage.
Les contrôles de santé et les listes de modèles n’ont pas été considérés comme des tests de chargement. Un test d’acceptation utile envoie une vraie requête, vérifie la réponse, confirme le GPU choisi, observe l’arrêt et vérifie la reprise du minage.
Dépannage de la flotte
| Symptôme | Première vérification |
|---|---|
| Le modèle apparaît, mais les requêtes échouent | Identifiant du modèle amont, format d’API, en-tête d’authentification et URL de base du fournisseur |
| Aperture renvoie 405 | La racine du fournisseur ne contient pas de suffixe /v1 en double |
| Le mauvais nœud sert la requête | Alias partagé ou alias préfixé par un nœud |
| Deux workers ciblent la même carte | Verrou de bail, état des baux périmés et logique d’admission des GPU |
| Le minage s’arrête sur chaque carte | Le code de redémarrage du mineur construit sa liste d’appareils à partir des baux actifs |
| Un GPU reste hors du minage | Arbre de processus du worker, réconciliation des baux et liste d’appareils du mineur |
| Le chargement à froid est lent | Taille du modèle, vitesse du stockage, largeur de liaison PCIe et charge du processeur hôte |
| Les longues invites échouent | Contexte configuré, marge du cache KV et réserve de sortie |
| Le parcours d’embeddings manque dans Aperture | Utiliser le parcours LiteLLM authentifié, restreint par l’identité Tailscale et le pare-feu de l’hôte |
| L’arrêt du broker se bloque | Désactiver le parcours du broker et renvoyer le trafic vers le proxy de pool vérifié |
Règles de conception à conserver
- Router selon le but de la tâche. La taille du modèle ne définit pas seule un niveau.
- Placer la politique au-dessus du placement. Hermes choisit un alias de capacité. LiteLLM choisit un déploiement. Le pool choisit un GPU.
- Traiter chaque GPU comme un bail distinct. Le basculement de tout l’hôte gaspille les cartes disponibles.
- Décharger chaque modèle inactif. Des passerelles actives n’exigent pas de workers GPU actifs.
- Conserver un parcours de placement exact et restreint. Les alias de nœuds réservés aux opérateurs rendent les diagnostics reproductibles.
- Tester d’abord l’arrêt. La reprise du mineur et le nettoyage des baux font partie des tests d’acceptation.
- Séparer discussion, vision et embeddings. Une passerelle unique n’implique pas un parcours de protocole unique.
- Exclure les détails privés des schémas. Publier les rôles et les flux, pas les adresses, clés, identités ou données de portefeuille.
- Protéger la logique de redémarrage. Exiger des absences répétées, un délai de refroidissement, un compteur persistant, une alerte et une intervention manuelle après un échec de reprise.
- Conserver un parcours de contournement expérimental. L’échec d’un broker ne doit pas entraîner le parcours vérifié avec lui.
Étapes suivantes
La prochaine phase évalue les charges de travail. Chaque niveau nécessite un ensemble fixe de tâches, des critères d’acceptation, des mesures de latence, l’occupation GPU, la durée d’interruption du minage et les taux d’escalade. Ces mesures indiqueront quelles tâches T2 conviennent à T3 et lesquelles de T3 tiennent dans T4.
Nous prévoyons aussi d’exécuter le premier test d’acceptation Hermes vers Aperture vers LiteLLM, puis de retester le broker après correction de ses parcours d’arrêt et d’admission GPU. La génération d’images nécessite son propre adaptateur OpenAI compatible à chargement différé avant de rejoindre le même catalogue de routage.
Pour dimensionner les modèles, consultez le guide du contexte des modèles d’IA locaux et des GPU . Pour les frontières de confidentialité, lisez Confidentialité et sécurité de l’IA locale . Pour la configuration du mineur et ses risques, lisez le guide de minage Pearl au lieu de considérer le minage au repos comme une source de profit garantie.
Related Posts