16 Go de VRAM suffisent-ils pour un travail LLM local sérieux ?
Table of Contents
16 Go de mémoire GPU dédiée prennent en charge un travail LLM local sérieux lorsque le modèle, le contexte et le runtime tiennent ensemble. Le chargement des poids ne prouve que la première condition. Une configuration utile a aussi besoin de suffisamment de mémoire pour votre conversation en cours et d’une vitesse suffisante pour terminer votre tâche.
Utilisez Qwen3.8 27B comme exemple pour budgétiser un flux de travail de codage ou de documents pour un seul utilisateur. Commencez par le contexte dont votre tâche a besoin, puis choisissez des poids et des paramètres de runtime qui tiennent dans la mémoire restante. Les spécifications matérielles et les sources du modèle ont été vérifiées le 7 octobre 2026.
Points essentiels
- Réservez de la mémoire pour le contexte avant de choisir une quantification.
- Mesurez le traitement des prompts séparément de la vitesse de sortie.
- Désactivez le support de vision inutilisé et testez un cache KV 8 bits.
- Comparez le GPU exact, le backend, le fichier du modèle et la longueur du prompt.
- Calculez les économies de possession à partir de votre charge de travail et de votre facture fournisseur.
Pour l’exercice de budgétisation, vous avez besoin du journal mémoire de votre runtime, du nom exact du fichier de modèle et d’une tâche représentative. Prévoyez environ 20 minutes pour la configuration et l’enregistrement des résultats, plus le temps d’inférence. La difficulté est intermédiaire.
Adapter la mémoire au travail
16 Go conviennent à une charge dont les poids, le contexte actif et les allocations temporaires restent dans la mémoire GPU disponible. Le contexte requis dépend de la tâche. Un bref résumé de document et un agent de codage qui lit des dizaines de fichiers ont besoin de budgets différents.
| Charge de travail | Première question de dimensionnement |
|---|---|
| Chat court ou rédaction | Le modèle atteint-il votre objectif de qualité ? |
| Analyse de documents | Le texte source et la réponse tiennent-ils ensemble ? |
| Agent de codage | Quelle quantité de contexte les fichiers et les résultats d’outils consomment-ils ? |
| Requêtes simultanées | De quelle quantité de cache chaque session active a-t-elle besoin ? |
Une fenêtre configurée diffère d’une fenêtre occupée. Un benchmark avec une limite de 64K et un prompt court ne mesure pas la génération après 55K tokens de conversation. Testez près de la longueur attendue de votre session avant de choisir le matériel.
Pourquoi le modèle tient
La quantification stocke les poids avec moins de bits. Le tableau des fichiers Qwen3.8 27B de Bartowski indique 17.44 GB pour Q4_K_M, déjà au-delà des environ 17.18 milliards d’octets d’un appareil de 16 GiB avant la mémoire du runtime.
La fiche du modèle GSQ-RCO d’ISTA-DASLab indique 11.8 GB pour IQ3_S. Sa méthode attribue une précision différente aux tenseurs selon un budget de taille. La version MTP optionnelle ajoute environ 0.35 GB, tandis que le projecteur de vision ajoute environ 0.9 GB.
| Benchmark publié | Score BF16 / IQ3_S |
|---|---|
| AIME25 | 100.00 / 100.00 |
| LiveCodeBench v6 | 85.71 / 85.71 |
| GPQA-Diamond | 89.90 / 89.39 |
Le laboratoire appelle ce point de fonctionnement « task-lossless ». Ces résultats sélectionnés soutiennent une comparaison étroite. Ils ne prouvent ni des réponses identiques, ni une récupération égale sur long contexte, ni une fiabilité égale pour vos tâches de codage. Testez le modèle compressé selon vos propres critères d’acceptation.
Compter le cache
Le cache KV stocke les clés et les valeurs d’attention des tokens déjà traités. Votre prompt, la sortie des outils et les réponses générées consomment du contexte. Certains runtimes allouent la capacité du cache au démarrage. La mémoire affichée ne doit donc pas forcément augmenter à chaque message.
La configuration de Qwen indique 64 couches, une attention complète à chaque quatrième couche, quatre têtes KV et une dimension de tête de 256. Pour ces 16 couches à attention complète, le coût calculé du cache FP16 est :
16 layers × 4 KV heads × 256 elements × 2 (K and V) × 2 bytes
= 65,536 bytes per token
= 64 KiB per token
Ce calcul exclut l’état récurrent, l’alignement, les tampons temporaires et les allocations du décodage spéculatif. Les autres architectures nécessitent des calculs différents.
| Tokens occupés | Cache d’attention complète FP16 |
|---|---|
| 32,768 | 2 GiB |
| 65,536 | 4 GiB |
| 131,072 | 8 GiB |
| 262,144 | 16 GiB |
Ici, KiB et GiB utilisent des puissances de 1024. Les tailles de téléchargement des modèles utilisent des GB décimaux. Mélanger les unités déforme le budget restant.
Budgéter votre contexte disponible
Deux paramètres libèrent de la mémoire pour des sessions de texte plus longues : supprimer un projecteur de vision inutilisé et réduire la précision du cache. Calculez leur effet par rapport à votre modèle chargé et aux allocations du runtime.
Utilisez cet exemple, avec chaque allocation exprimée en GB décimaux. La réserve de 1.0 GB ci-dessous est une hypothèse de planification, pas une valeur par défaut universelle du runtime.
| Allocation | Vision activée / vision désactivée |
|---|---|
| Capacité physique de 16 GiB | 17.180 / 17.180 GB |
| Poids du modèle | 11.800 / 11.800 GB |
| Tête MTP optionnelle | 0.350 / 0.350 GB |
| Estimation du projecteur de vision | 0.930 / 0 GB |
| Autres allocations supposées | 1.000 / 1.000 GB |
| Disponible pour le cache croissant | 3.100 / 4.030 GB |
À 65,536 octets par token, 3.100 GB contiennent environ 47,300 tokens. Avec le stockage 8 bits idéal, 32,768 octets par token permettent environ 123,000 tokens lorsque la vision est désactivée.
Le stockage q8_0 réel inclut les échelles de blocs. À raison de 34 octets pour 32 valeurs, cet exemple nécessite environ 34,816 octets par token, ce qui réduit l’estimation à environ 115,700. Les allocations supplémentaires réduisent encore le résultat. Environ 110K est donc un résultat de planification plausible dans ces hypothèses, pas un paramètre garanti.
Le contexte restant doit couvrir l’entrée et la sortie. Avec une fenêtre de 65,536 tokens, un prompt initial illustratif de 30,000 tokens et une capacité de sortie de 8,192 tokens laissent 27,344 tokens pour les fichiers, les résultats d’outils et la conversation. Le budget du prompt initial est un exemple. Mesurez vos propres outils et instructions.
Paramètres à tester
La documentation du serveur llama.cpp documente des types séparés pour les caches de clés et de valeurs, le chargement automatique du projecteur et les slots parallèles. Pour une charge de texte uniquement, testez la vision désactivée, q8_0 pour les deux types de cache et un slot. Commencez avec un contexte modeste.
Notez les allocations obtenues avant d’augmenter le contexte. La quantification du cache doit être prise en charge par l’architecture et le backend choisis. Testez la qualité des réponses après avoir changé la précision. Gardez une configuration fonctionnelle pour comparaison.
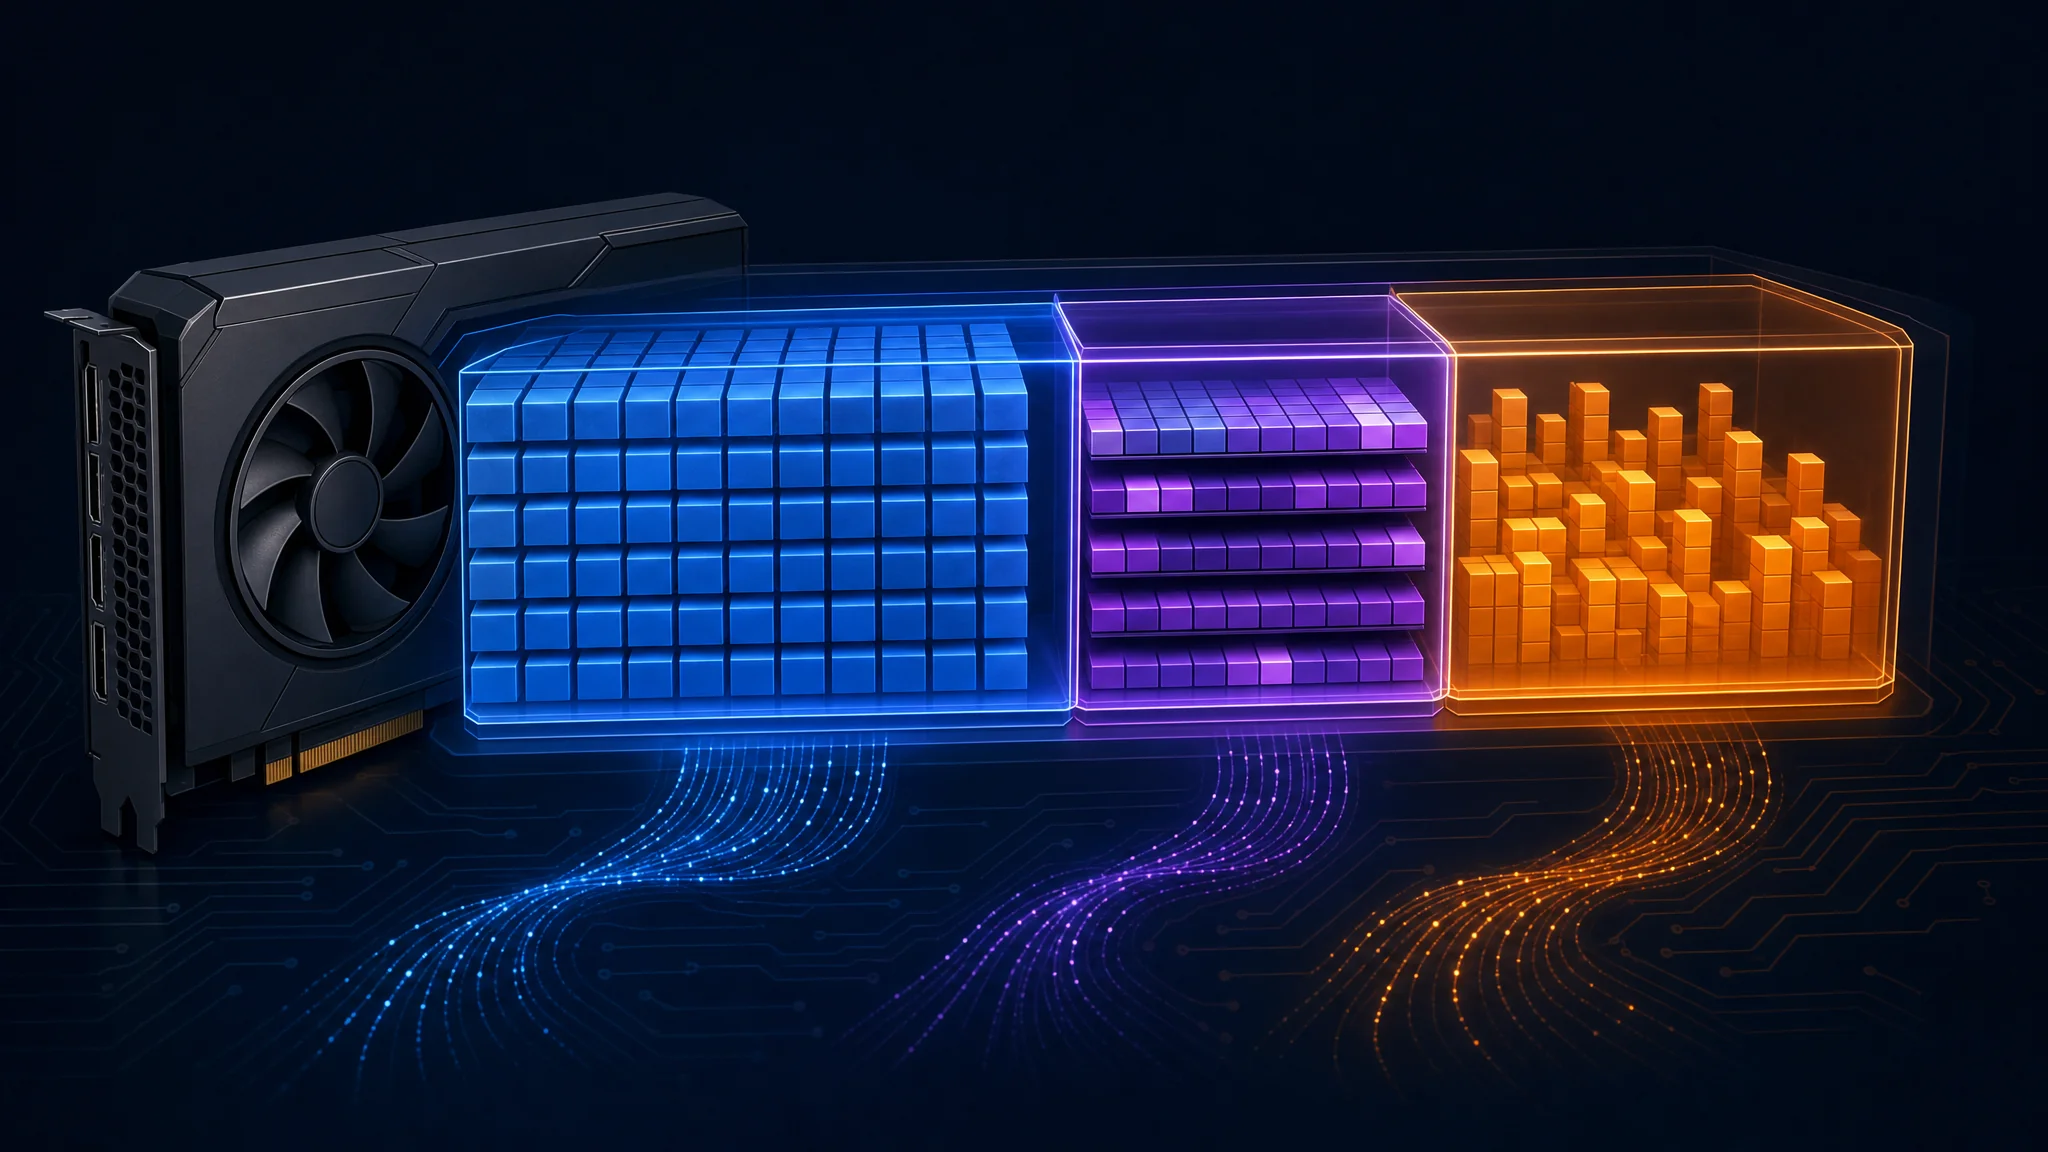
Le bleu représente les poids, le violet le cache de contexte et l’orange les allocations du runtime. Les tailles sont illustratives
Pourquoi les vitesses diffèrent
Une mention 16GB décrit la capacité. Le débit dépend aussi de la bande passante mémoire, des noyaux de calcul, du contexte actif, du déport, du batching et du décodage spéculatif.
| Cause | Élément à inspecter |
|---|---|
| Déport vers le CPU ou la RAM | Placement des couches chargées et emplacement du cache |
| Contexte long | Tokens occupés pendant la mesure |
| Différences de backend | Commit du runtime, pilote et chemin du noyau |
| Décodage spéculatif | Brouillons acceptés et allocations supplémentaires |
Pour un modèle dense qui génère un token à la fois, la bande passante mémoire divisée par les octets de poids résidents donne une estimation approximative fondée uniquement sur la bande passante. À 448 GB/s et 11.8 GB de poids, le quotient est d’environ 38 tokens par seconde. Les lectures du cache et le calcul ajoutent du travail, tandis que le décodage spéculatif et le batching changent les hypothèses.
Ne traitez pas ce quotient comme une limite supérieure universelle. Un débit de sortie rapporté plus élevé n’invalide pas automatiquement un benchmark. Vérifiez si un passage du modèle cible a accepté plusieurs tokens brouillons.
La prédiction multi-token, ou MTP, a besoin d’un modèle et d’un runtime compatibles. Comparez les exécutions activées et désactivées avec un contexte occupé court et long. Les poids supplémentaires et l’état des brouillons consomment de la mémoire, mais aucune règle universelle n’impose de désactiver MTP après 32K tokens.
Mesurer la première réponse
Le prefill traite le prompt avant la génération. Le decode produit la réponse. Un résultat de decode rapide cache une première réponse lente lorsqu’une tâche commence par un grand prompt non mis en cache.
Divisez les tokens du prompt non mis en cache par le débit de prefill mesuré pour estimer le temps de traitement du prompt. Pour un prompt frais de 30,000 tokens, deux débits illustratifs donnent ces attentes :
| Débit de prompt d’exemple | Temps de traitement calculé |
|---|---|
| 750 tokens/s | 40 secondes |
| 150 tokens/s | 200 secondes |
Ces exemples décrivent le temps de traitement, hors chargement du modèle et surcharge de la requête. La longueur du prompt, la taille du batch, le format du modèle et le backend influencent votre débit mesuré.
Mesurez séparément une requête froide et une continuation avec un préfixe réutilisable. La réutilisation du préfixe évite de traiter une partie de l’entrée répétée. Notez le délai jusqu’au premier token avec le débit de decode et la durée totale de la tâche.
Comparer des configurations GPU complètes
Comparez ensemble le prix d’achat, la mémoire utilisable, la bande passante et le chemin logiciel. Une carte moins chère perd son avantage si votre charge nécessite des fonctions non prises en charge ou dépasse votre objectif de latence.
| Carte de bureau 16GB | Bande passante mémoire |
|---|---|
| RX 9060 XT | 320 GB/s |
| RTX 5060 Ti | 448 GB/s |
| RX 9070 | 640 GB/s |
| RX 9070 XT | 640 GB/s |
Les spécifications de la RX 9070 d’AMD et les spécifications de la RX 9070 XT confirment leur capacité de 16GB et une bande passante allant jusqu’à 640 GB/s. La comparaison 640 contre 448 donne environ 43 % de bande passante théorique en plus. Une amélioration de 43 % de l’inférence ne découle pas de ces seules spécifications.
Choisissez des benchmarks utilisant votre modèle et votre backend prévus. Pour les prompts courts et la génération soutenue, donnez plus de poids aux performances de decode. Pour l’analyse d’un dépôt, donnez la priorité au prefill à froid, à la vitesse sur long contexte et à la réussite de la tâche. Vérifiez les logiciels disponibles avant d’acheter l’un ou l’autre fabricant.
Mac et appellations des ordinateurs portables
Un Mac Apple silicon de 16GB partage sa mémoire entre le CPU, le GPU, le système d’exploitation et les applications. Un GPU discret de 16GB possède une mémoire vidéo dédiée en plus de la RAM système. Ces capacités ne décrivent pas des budgets de modèle équivalents.
Apple expose une taille recommandée de working set GPU . Examinez la limite rapportée par votre runtime et la pression mémoire du système. Laissez de la place pour macOS et vos autres applications au lieu de réserver tout le pool partagé à l’inférence.
Pour les ordinateurs portables, vérifiez le SKU exact du fabricant, la mémoire dédiée, la limite de puissance du GPU et le refroidissement. La page de la famille RTX 5060 de NVIDIA répertorie les variantes de mémoire de la RTX 5060 Ti de bureau. Un nom de famille ne garantit pas 16GB, et les résultats de bureau ne garantissent pas le débit d’un ordinateur portable.
La possession est-elle rentable ?
La possession devient rentable lorsque les frais d’hébergement évités dépassent les coûts d’exploitation et remboursent l’achat du matériel. Commencez par un exemple limité à la sortie : une carte à 789 $, 35 tokens de sortie/s, 180 W pendant la génération, 0,18 $/kWh d’électricité et 2,95 $ par million de tokens de sortie hébergés. Ces valeurs sont illustratives. Remplacez-les par votre devis, votre puissance mesurée, votre tarif d’électricité et les prix du fournisseur.
Hours per million output tokens = 1,000,000 ÷ 35 ÷ 3,600 = 7.94
Electricity per million = 7.94 × 0.180 kW × $0.18/kWh = $0.257
Savings per million = $2.95 - $0.257 = $2.693
Break-even output = $789 ÷ $2.693 = 293 million tokens
Continuous generation time = 293 × 7.94 ÷ 24 = about 97 days
Avec huit heures de génération ininterrompue par jour, le même calcul prend environ 291 jours. Huit heures avec un assistant ouvert diffèrent de huit heures à générer des tokens.
À un prix de sortie hébergé de 0,16 $ par million, l’électricité locale de ce scénario coûte déjà plus cher que l’hébergement. Il n’existe aucun seuil de rentabilité positif limité à la sortie dans ces hypothèses.
Utilisez les prix actuels des modèles OpenRouter du fournisseur choisi, y compris les frais d’entrée et d’entrée mise en cache. Mesurez l’énergie de tout le système, y compris le prefill. Ajoutez les mises à niveau, l’énergie au repos, la maintenance et la valeur de revente attendue. Comparez le travail accepté, car les nouvelles tentatives et les différences de qualité modifient le coût par tâche.
Quand ajouter de la mémoire
Dépassez 16GB lorsque votre charge mesurée dépasse le contexte disponible avec une qualité et une latence acceptables. Les longues sessions quotidiennes d’agents, les requêtes simultanées ou les poids de plus haute précision rendent une capacité supérieure utile.
Deux cartes de 16GB nécessitent une prise en charge explicite du runtime. Elles ne deviennent pas une allocation transparente de 32GB. Chaque appareil a besoin de tampons, et les communications utilisent l’interconnexion de l’hôte.
| Stratégie de répartition | Principal compromis |
|---|---|
| Répartition des couches | Des couches différentes occupent des appareils différents |
| Répartition tensorielle ou par lignes | Le travail dans les couches ajoute des communications |
| CPU et GPU | Plus de capacité avec un profil de latence différent |
Une seconde carte mérite l’étude lorsque votre carte mère, votre alimentation, votre refroidissement et votre backend prennent déjà en charge le plan. Comparez le coût complet du système avec un GPU unique plus grand. Le guide matériel Qwen 32GB couvre ces options.
Dépannage et prochaines étapes
Si le chargement échoue, réduisez le contexte et inspectez les allocations. Si la vitesse baisse pendant une session, vérifiez le contexte occupé et le déport vers le CPU. Si la première réponse se bloque, mesurez le prefill à froid. Si l’utilisation des outils se casse après compression, comparez la même tâche avec un modèle de plus haute précision.
Enregistrez un test reproductible contenant vos instructions habituelles, vos fichiers et vos sorties d’outils. Notez la révision du modèle, la version du runtime, la précision du cache, le contexte occupé, la mémoire maximale, la latence du premier token, la vitesse de decode et la réussite de la tâche. Répétez le test près de la session la plus longue attendue.
Utilisez le guide des modèles locaux et du contexte pour comparer des alternatives plus petites. Choisissez le plus petit modèle qui atteint vos exigences de qualité, puis réservez assez de mémoire pour la tâche complète. Dans ces conditions, 16GB constituent une cible utile pour une station de travail.
Related Posts