Routage des fournisseurs OpenRouter : qualité des modèles, limites de tokens et coûts réels
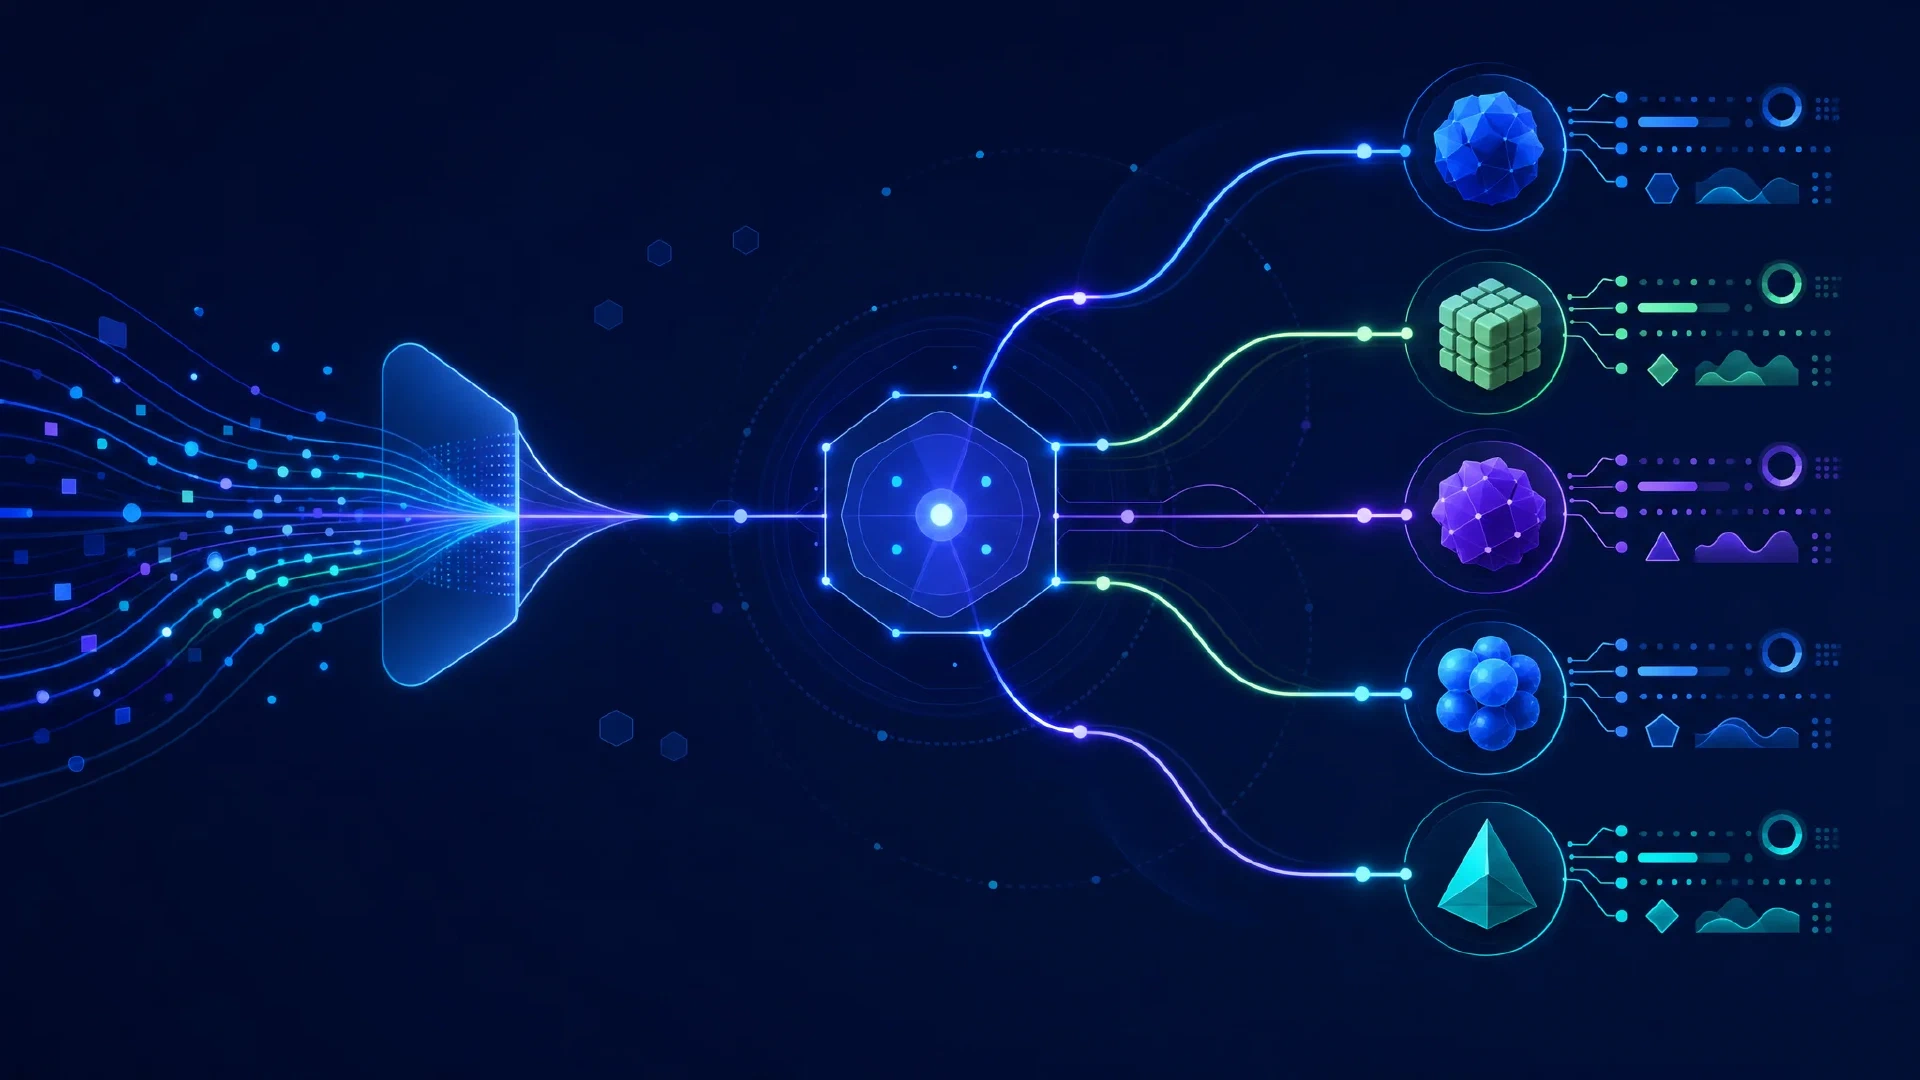
Table of Contents
Le routage des fournisseurs OpenRouter détermine le service d’inférence qui répond à votre demande. Deux appels utilisant le même nom de modèle dépendent encore des limites de l’endpoint, des paramètres pris en charge, du logiciel de service et des préférences de routage. Si les réponses deviennent plus courtes ou si les appels d’outils échouent, vérifiez ces différences avant d’accuser la quantification.
Points clés
- Les étiquettes de précision décrivent un format numérique, pas un score d’exactitude.
- Les limites de l’endpoint déterminent le contexte disponible, la longueur de sortie et la prise en charge des fonctions.
- Le routage explicite nécessite une règle de repli ainsi qu’une préférence de fournisseur.
- Auto Exacto améliore la sélection des fournisseurs avec des signaux de qualité et propose une route à activation volontaire pour les demandes sans outils.
- Le coût réel comprend la sortie, le comportement du cache, les nouvelles tentatives et la réussite de la tâche.
Prérequis : connaissance des requêtes JSON et accès à la configuration OpenRouter de votre application. L’inspection des endpoints utilise une API publique. L’envoi de requêtes de modèle nécessite une clé API et entraîne des frais d’utilisation. Vérifiez à nouveau les métadonnées de l’endpoint avant de répéter un exemple daté.
Durée et difficulté : environ 20 minutes pour une première revue de configuration. Niveau intermédiaire. Une comparaison utile entre fournisseurs nécessite des tests supplémentaires avec des prompts représentatifs.
Ce que votre nom de modèle ne précise pas
Un identifiant de modèle sélectionne le modèle demandé. Le fournisseur exécute le service d’inférence, avec son implémentation du modèle, ses limites de tokens et son analyseur d’appels d’outils. Un benchmark au niveau du modèle ne valide pas chaque service hébergeant ces poids.
| Propriété de l’endpoint | Vérification à effectuer |
|---|---|
| Longueur du contexte | Espace pour le prompt, l’historique, les résultats d’outils et la génération |
| Longueur maximale de completion | Budget de sortie pour la tâche demandée |
| Paramètres pris en charge | Utilisation des outils, sortie structurée, échantillonnage et contrôles de raisonnement |
| Quantification | Format annoncé comparé à la version originale |
| Tarification | Entrée, sortie, lectures du cache et frais supplémentaires applicables |
| Comportement du service | Qualité de completion, erreurs d’analyse, latence et nouvelles tentatives |
Le routage de base favorise les prix plus bas parmi les candidats opérationnels. OpenRouter documente une pondération inverse du carré du prix. Dans son exemple simplifié, un candidat à 1 $ reçoit neuf fois le poids de sélection d’un candidat à 3 $. Il s’agit de poids relatifs, pas d’une garantie pour votre prochaine requête. L’ordre explicite, le tri, la mise en cache et le routage par qualité influencent aussi la sélection. Consultez la documentation du routage des fournisseurs .
La pondération par prix ne prouve pas que votre facture sera la moins élevée. L’exemple documenté ne définit pas de mélange universel entre tokens d’entrée et de sortie pour son scalaire de prix. N’inférez pas la probabilité de sélection d’un fournisseur à partir du seul prix d’entrée.
Lire la précision dans son contexte
La quantification stocke les valeurs numériques avec une représentation réduite. Son effet dépend du modèle, de la méthode et de l’implémentation d’inférence. Une précision inférieure demande des tests, mais l’étiquette seule ne démontre pas qu’un fournisseur a modifié les poids originaux.
GPT-OSS fournit un exemple concret. La documentation de publication de gpt-oss-120b par OpenAI indique que ses poids de mélange d’experts utilisent MXFP4 et que ses évaluations ont utilisé la même quantification. Une étiquette quatre bits pour ces poids correspond à la publication. Elle ne prouve pas une dégradation supplémentaire chez le fournisseur.
La conversion ascendante transforme les valeurs stockées en une représentation plus large. Convertir un checkpoint déjà quantifié en BF16 ne récupère pas les informations supprimées pendant la quantification. À l’inverse, convertir un checkpoint originellement plus précis en quatre bits introduit un changement distinct à évaluer.
| Observation | Conclusion étayée |
|---|---|
| Checkpoint MXFP4 natif | Les poids experts quatre bits appartiennent à la publication |
| Étiquette BF16 de l’endpoint | Format annoncé plus large, sans preuve de meilleures réponses |
| Précision inconnue | Métadonnées manquantes, sans preuve d’une dégradation cachée |
| Étiquettes de précision identiques | Preuve insuffisante d’un comportement de service équivalent |
Des étiquettes identiques n’excluent pas non plus des différences de quantification. Elles ne précisent pas quels tenseurs ont été quantifiés, quelles méthodes d’étalonnage ont été choisies ni quels kernels sont exécutés. Testez l’endpoint complet au lieu de traiter la profondeur en bits comme un classement de qualité.
Vérifier le budget de tokens
curl --fail --silent --show-error \
  'https://openrouter.ai/api/v1/models/openai/gpt-oss-120b/endpoints' \
  | jq '.data.endpoints[] | {
      name,
      provider_name,
      context_length,
      max_completion_tokens,
      supported_parameters,
      quantization,
      pricing
    }'
L’API des endpoints expose les métadonnées du fournisseur pour un modèle. Cette commande nécessite curl et jq. Consultez la
réponse actuelle de l’endpoint gpt-oss-120b
avant de sélectionner un service. Traitez les champs absents ou nuls comme inconnus, et non comme illimités. Enregistrez un instantané local daté lors d’une comparaison.
Une vérification effectuée le 5 octobre 2026 a renvoyé ces limites annoncées pour gpt-oss-120b. Il s’agit de valeurs de métadonnées, pas de longueurs de completion mesurées, et les fournisseurs les modifient avec le temps.
| Fournisseur | Tokens de contexte | Tokens de completion maximum |
|---|---|---|
| DigitalOcean | 128,000 | 4,096 |
| Novita | 131,072 | 32,768 |
| Together | 131,072 | 117,964 |
La longueur du contexte et la longueur de sortie sont deux limites distinctes. Un modèle à long contexte a toujours besoin d’un espace suffisant pour sa réponse. L’historique, les instructions système et les définitions d’outils consomment de l’espace en plus du document utilisateur.
Les tokens de raisonnement consomment aussi le budget de génération sur les modèles qui les prennent en charge. Un petit budget risque de produire un raisonnement incomplet, une sortie visible réduite ou un arrêt avant la réponse finale. Inspectez l’utilisation et la raison de fin au lieu de supposer qu’une réponse courte reflète des poids moins bons. OpenRouter explique ce budget dans sa documentation sur les tokens de raisonnement .
Un max_tokens explicite donne au routeur une longueur de sortie demandée à comparer avec la prise en charge du fournisseur. Choisissez-la d’après les besoins mesurés de la tâche et l’espace de contexte disponible. Une valeur excessive réduit l’éligibilité et ne garantit pas une réponse plus longue ou meilleure.
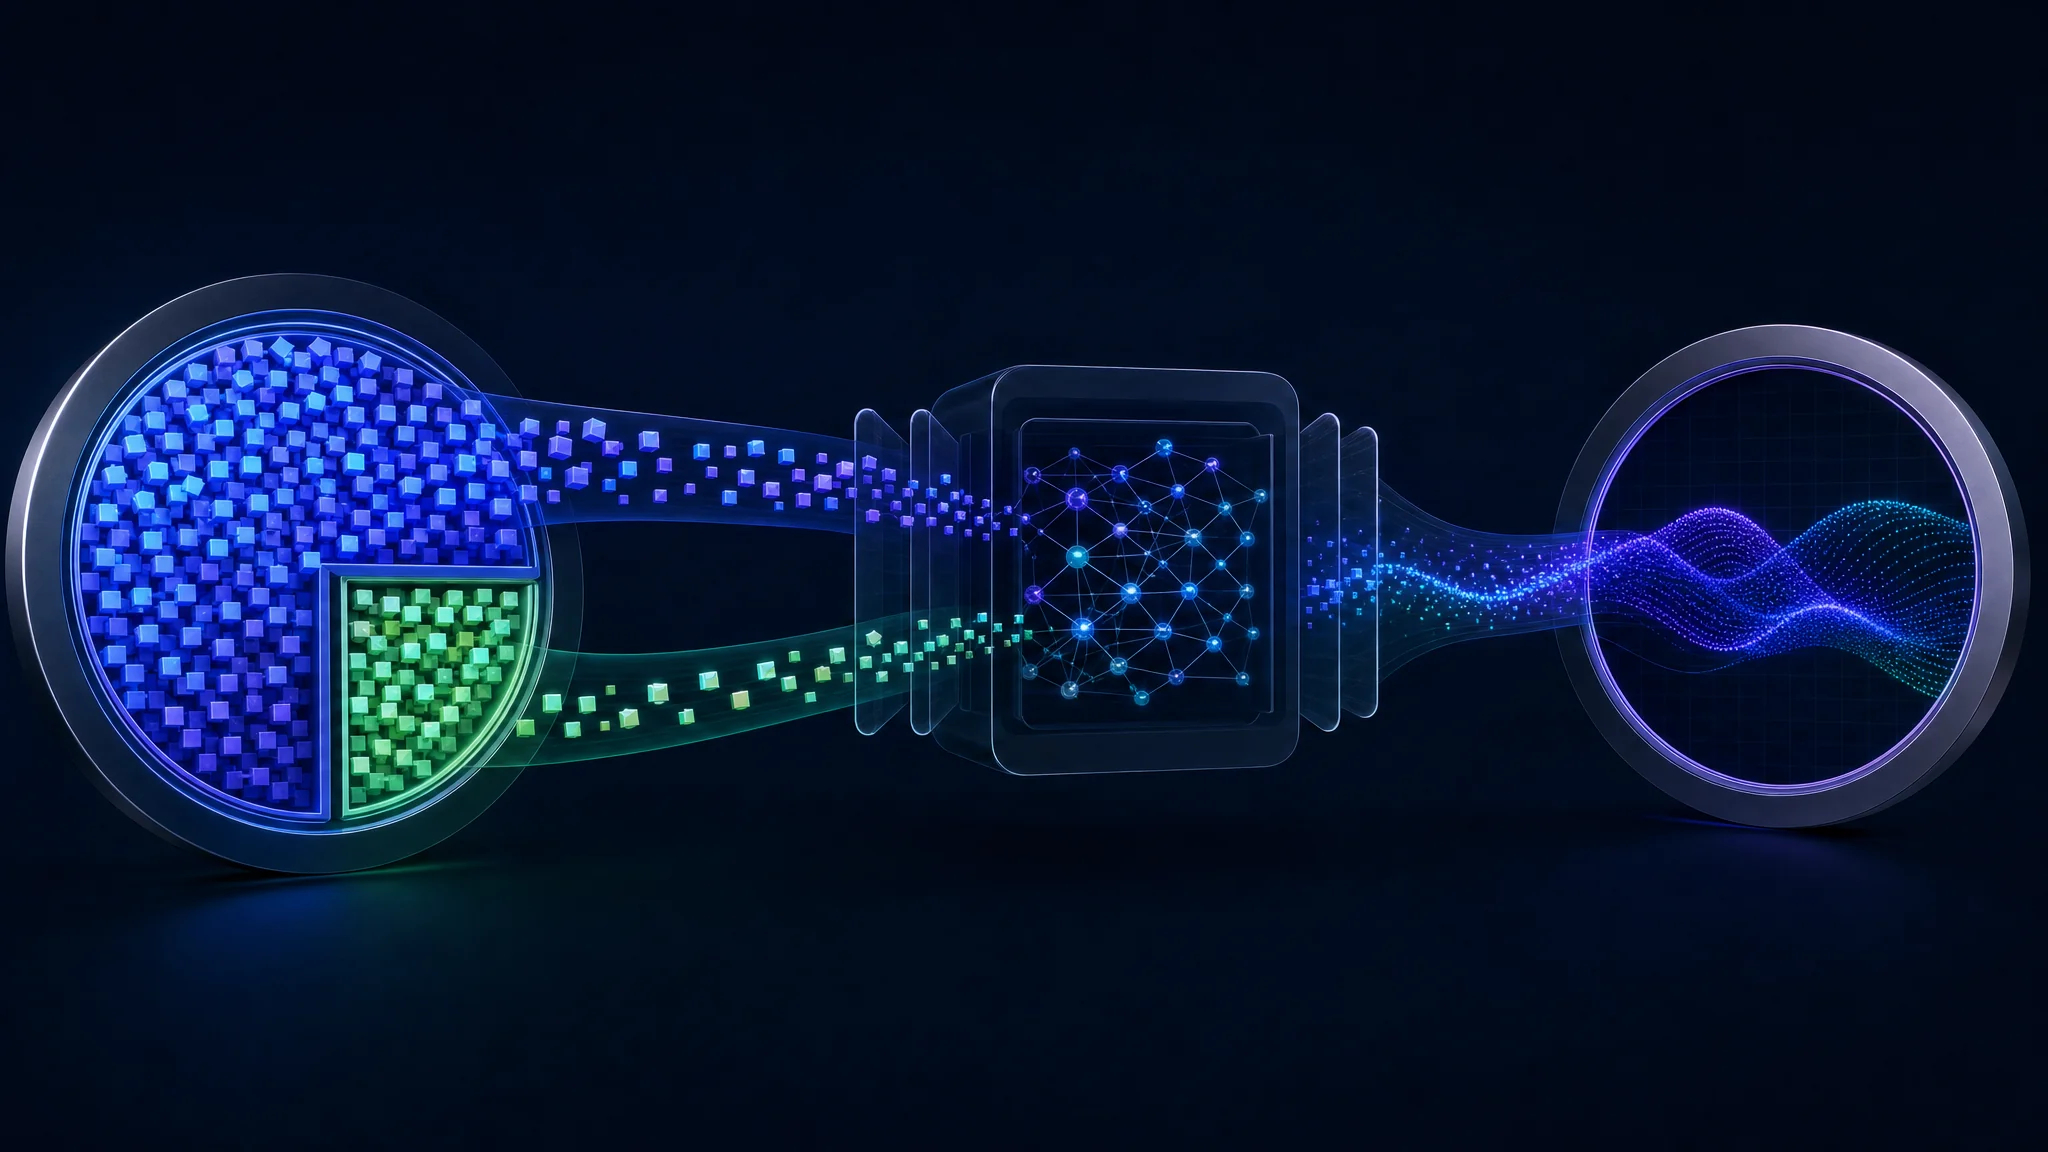
Allocation conceptuelle des tokens, avec le raisonnement et la sortie visible partageant le budget de completion chez les fournisseurs compatibles
Exiger vos paramètres
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Explain the failure modes of a retry loop."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
require_parameters vaut false par défaut. Avec le routage par défaut, les paramètres non pris en charge n’excluent pas forcément un endpoint. OpenRouter documente que les fournisseurs ignorent les paramètres inconnus. Passer ce champ à true filtre le routage selon la prise en charge déclarée.
Les métadonnées de prise en charge ne garantissent pas le comportement. Un endpoint annonçant la prise en charge de seed exige encore des tests de reproductibilité. Un endpoint compatible avec les outils exige encore une validation du schéma et des tests au niveau de l’application. Le filtre empêche les incompatibilités connues d’entrer dans l’ensemble des candidats.
Épingler les fournisseurs volontairement
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Summarize the supplied incident report."}
  ],
  "max_tokens": 8192,
  "provider": {
    "order": ["REPLACE_WITH_VERIFIED_PROVIDER_SLUG"],
    "allow_fallbacks": false,
    "require_parameters": true
  }
}
Remplacez le placeholder par un slug de fournisseur copié depuis la liste des fournisseurs du modèle. Fournissez le rapport dans votre vraie requête. Ce modèle sert à revoir la configuration. Il ne devient exécutable qu’après le remplacement du placeholder.
order établit une préférence. À lui seul, il laisse les repli vers d’autres fournisseurs activés. L’associer à allow_fallbacks: false limite le routage aux fournisseurs listés. Attendez-vous à une requête en échec si aucun ne satisfait la demande ou ne reste disponible.
Les variantes d’endpoint demandent de l’attention. Un slug de fournisseur de base correspond à plusieurs variantes selon les règles de correspondance documentées. Utilisez le slug de variante précis pour tester une configuration de service donnée. Vérifiez à nouveau le fournisseur indiqué dans chaque réponse.
quantizations est une liste blanche de formats nommés, et non un minimum numérique. Un tableau contenant "fp8" sélectionne les endpoints FP8 correspondants. Il n’inclut pas automatiquement BF16 ni tous les formats qui utilisent davantage de bits. Comparez d’abord le checkpoint original, puis appliquez ce filtre si votre évaluation justifie cette restriction.
Garder le routage qualité activé
{
  "model": "openai/gpt-oss-120b:exacto",
  "messages": [
    {"role": "user", "content": "Compare the two supplied incident reports."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
Auto Exacto utilise le débit, la télémétrie des appels d’outils et les benchmarks pour réduire la priorité des fournisseurs moins performants. L’ annonce de mars 2026 d’OpenRouter rapporte une baisse de 88 % des erreurs d’appels d’outils de GLM-5, avec un taux passant d’environ 8 % à près de 1 %. Elle rapporte aussi un passage de gpt-oss-120b de 5,6 % à 3,5 %.
Ces résultats proviennent du fournisseur, et ne constituent pas une promesse pour votre application. La validité d’un appel d’outil mesure le JSON, les noms et les schémas. Un appel syntaxiquement valide doit encore contenir les bons arguments et déclencher l’action correcte pour la tâche de l’utilisateur.
Les requêtes contenant des outils reçoivent Auto Exacto par défaut lorsque le modèle dispose d’une couverture suffisante. Pour les autres requêtes, :exacto active le routage qualité. La documentation actuelle prend donc en charge le routage qualité pour les résumés et le chat, ainsi que pour l’utilisation des outils.
sort: "price", le suffixe :floor et un tri par prix défini au niveau du compte désactivent Auto Exacto. Vérifiez ensemble les paramètres de l’application et les préférences du compte. Consultez la
documentation Auto Exacto
avant de combiner des contrôles de routage.
Calculer le coût de votre charge
Le prix d’entrée seul donne une comparaison incomplète. Prenez ces tarifs illustratifs, exprimés en dollars par million de tokens. Ils montrent le calcul et ne représentent pas des devis actuels de fournisseurs.
| Endpoint illustratif | Prix d’entrée | Prix de sortie |
|---|---|---|
| A | $0.03 | $16.00 |
| B | $0.42 | $1.32 |
Workload: 6 million input tokens + 1 million output tokens

A = 6 × $0.03 + 1 × $16.00 = $16.18
B = 6 × $0.42 + 1 × $1.32  =  $3.84

Per million combined input and output tokens:
A = $16.18 / 7 = $2.31
B =  $3.84 / 7 = $0.55
L’endpoint A coûte environ 4,2 fois plus cher pour ce mélange malgré son prix d’entrée inférieur. Le ratio de 533 pour 1 entre les prix de sortie et d’entrée de A compare deux tarifs. Il ne multiplie pas le coût total de l’utilisateur. Modifier les proportions d’entrée et de sortie modifie la comparaison.
Les unités de tarification de l’API diffèrent des tableaux de comparaison. L’API des endpoints exprime les prix des tokens par token. Multipliez-les par un million avant de les comparer aux tarifs ci-dessus.
La mise en cache des prompts ajoute une autre variable. Les lectures du cache, les écritures du cache et les entrées sans cache exigent un calcul séparé selon les règles de facturation du fournisseur. Un texte répété ne garantit pas un accès au cache. Vérifiez les nombres et les coûts de tokens mis en cache dans la documentation sur la mise en cache des prompts .
Le routage influence la continuité du cache. OpenRouter documente un routage persistant pour le cache, tandis que l’ordre manuel des fournisseurs est prioritaire. Auto Exacto réordonne aussi les fournisseurs et interrompt parfois un cache chaud. Comparez les économies de cache observées avec les coûts de qualité et de nouvelles tentatives avant de modifier l’une ou l’autre politique.
Le coût par résultat accepté est la mesure utile pour l’application. Divisez les dépenses totales, y compris les nouvelles tentatives et les échecs, par le nombre de résultats respectant vos critères d’acceptation. Séparez les frais hors tokens applicables. Un tarif de tokens bas ne compense pas des tâches échouées à répétition.
Diagnostiquer une réponse incohérente
| Symptôme | Première vérification |
|---|---|
| Réponse courte ou inachevée | Raison de fin, budget de sortie, utilisation du raisonnement |
| Détails du document absents | Contenu envoyé, limite de contexte de l’endpoint, troncature du client |
| Appel d’outil mal formé | Prise en charge annoncée, schéma d’outil, comportement de l’analyseur |
| Comportement d’échantillonnage différent | Paramètres demandés et prise en charge déclarée |
| Dépense inattendue | Volume de sortie, lectures du cache, nouvelles tentatives, changements de fournisseur |
| Aucun fournisseur éligible | Limites contradictoires, listes blanches et restrictions de repli |
Conservez l’identifiant de génération renvoyé avec la réponse. L’ API de métadonnées de génération d’OpenRouter expose l’identité du fournisseur, l’utilisation, le coût et les informations de fin. Un identifiant de session regroupe le travail associé, mais ne remplace pas l’identifiant de génération pour une requête unique.
Enregistrez la requête avec l’identifiant de génération. Conservez le modèle, les préférences de fournisseur, les paramètres demandés, l’horodatage et l’utilisation de la réponse ensemble. Une comparaison ultérieure de qualité ou de coût devient reproductible lorsque le routage, les prix ou les métadonnées d’endpoint changent.
Comparez les endpoints dans des conditions identiques. Utilisez le même prompt, les mêmes outils, les mêmes paramètres de raisonnement et le même budget de tokens. Répétez sur plusieurs tâches représentatives. Séparez les réponses incomplètes, les appels d’outils invalides et les mauvaises réponses au lieu de les fusionner dans un score de qualité inexpliqué.
L’incertitude des benchmarks compte. L’ analyse d’Epoch AI sur le benchmarking décrit des variations liées aux implémentations, à l’échantillonnage et aux architectures d’agents. Une réponse décevante ne prouve pas un défaut persistant du fournisseur ni sa cause.
Démonstration du routage des endpoints
Pour aller plus loin : Discussion sur la qualité et le routage des endpoints OpenRouter . Vérifiez à nouveau les listes d’endpoints avant d’appliquer des prix, des limites ou des comparaisons de fournisseurs précis.
Prochaines étapes
- Inspectez les endpoints d’un modèle et notez les limites utiles pour votre charge.
- Choisissez une politique de routage avec des exigences explicites sur les paramètres et le comportement de repli.
- Testez des tâches représentatives contre les endpoints candidats et le routage qualité.
- Notez le coût par résultat accepté avec la latence, l’utilisation du cache et les catégories d’échec.
- Vérifiez à nouveau après les changements de version du modèle, de comportement du service ou de prix du fournisseur.
Pour les fondamentaux de l’IA, poursuivez avec Concepts de base de l’IA . Pour les permissions des agents et les contrôles de validation, lisez Sécuriser les systèmes d’IA .
Related Posts