Coder avec une IA locale sur un GPU de 16 Go : Strata, OpenCode et Qwen3.8
Table of Contents
Un agent de codage local sur un GPU de 16 Go convient aux tâches de développement délimitées. Strata et OpenCode associent l’inférence locale à l’édition de fichiers, aux commandes shell et à l’exécution de tests. Une exécution rapportée de Qwen3.8-Flash-Next sur une RTX 4060 Ti a terminé une application, des modifications ultérieures et un prototype de jeu de course sans appels d’inférence payants.
Remplacer un abonnement demande un test plus large. Les résultats publiés montrent une configuration fonctionnelle sur une machine. Ils ne démontrent pas une équivalence avec les services de codage payants pour plusieurs langages, dépôts ou tâches de débogage difficiles. Le matériel comprend aussi 64 Go de mémoire système, qui prend en charge une grande partie du modèle.
Points essentiels
- 16 Go désigne la mémoire du GPU, pas la mémoire totale requise par la configuration rapportée.
- La réutilisation des prompts compte, car les agents de codage envoient souvent un historique de conversation partiellement identique.
- Le raisonnement a besoin d’un budget pour laisser de la place au code et aux appels d’outils.
- La réussite des tests générés fournit seulement une preuve partielle, tandis que Docker et le jeu demandent des vérifications séparées.
- L’absence de dépense d’API exclut les coûts de possession, l’électricité et le temps de maintenance.
Prérequis : Un ordinateur compatible, assez d’espace libre pour le modèle choisi, Git, Node.js avec npm et une certaine familiarité avec les outils du terminal. Reproduisez la configuration IQ3_S rapportée avec 64 Go de RAM. Utilisez l’installateur Strata actuel pour vérifier les autres configurations.
Durée et difficulté : Intermédiaire. Prévoyez du temps pour les téléchargements volumineux et l’installation avant d’évaluer la vitesse d’exécution des tâches. Les durées rapportées excluent la préparation.
Configuration testée
| Composant | Configuration rapportée |
|---|---|
| GPU | NVIDIA RTX 4060 Ti, 16 Go de VRAM |
| CPU | Intel Core i5-11600K |
| Mémoire système | 64 Go de RAM |
| Stockage | SSD NVMe |
| Modèle | Qwen3.8-Flash-Next, MoE 125B, IQ3_S |
| Moteur d’inférence | Strata |
| Agent de codage | OpenCode |
| Contexte configuré | 65 536 tokens |
| Limite de sortie configurée | 16 384 tokens |
La configuration et les résultats publiés par NetworkCoder fournissent ces chiffres. Le dépôt de test indique le chargement de 46.84GiB de poids d’experts en 28 secondes, avec 4 431 experts occupant 8.45GiB de mémoire GPU. Ces mesures décrivent l’exécution testée et ne garantissent pas la même allocation avec une autre version du moteur.
La compatibilité actuelle dépasse ce test. Vérifié le 6 octobre 2026, le projet Strata documente certaines cartes NVIDIA et AMD avec au moins 12 Go de VRAM, ainsi que des modèles plus petits pour les systèmes équipés de 32 Go de RAM. Ces options ne reproduisent pas l’expérience avec un GPU de 16 Go, 64 Go de RAM et IQ3_S. Vérifiez le GPU exact, la variante du modèle et la prise en charge du moteur avant d’acheter du matériel.
Où se trouve le modèle
Un mélange d’experts, ou MoE, active un sous-ensemble des réseaux d’experts d’un modèle pour chaque token. Cela réduit le calcul actif par rapport à l’utilisation de tous les paramètres à chaque étape. Les poids restants ont toujours besoin d’un stockage et d’un chemin vers le calcul.
L’exécution hybride de Strata conserve les experts fréquemment utilisés sur le GPU tout en gardant l’ensemble des experts dans la RAM système. Le CPU calcule sur place les experts non mis en cache, tandis que le GPU traite les experts en cache. Le stockage contient aussi les fichiers du modèle et les données de recherche. Le système ne fait pas tenir le modèle 125B entier dans 16 Go de VRAM.
La mémoire GPU a plusieurs usages concurrents. Les allocations d’exécution, l’état d’attention et le cache d’experts se partagent une ressource limitée. Donner plus de place au contexte modifie la capacité restante du cache d’experts. Les versions actuelles de Strata prennent aussi en charge le streaming du cache KV, donc le placement exact diffère d’une ancienne configuration. Consultez la documentation technique correspondant à votre version du moteur.
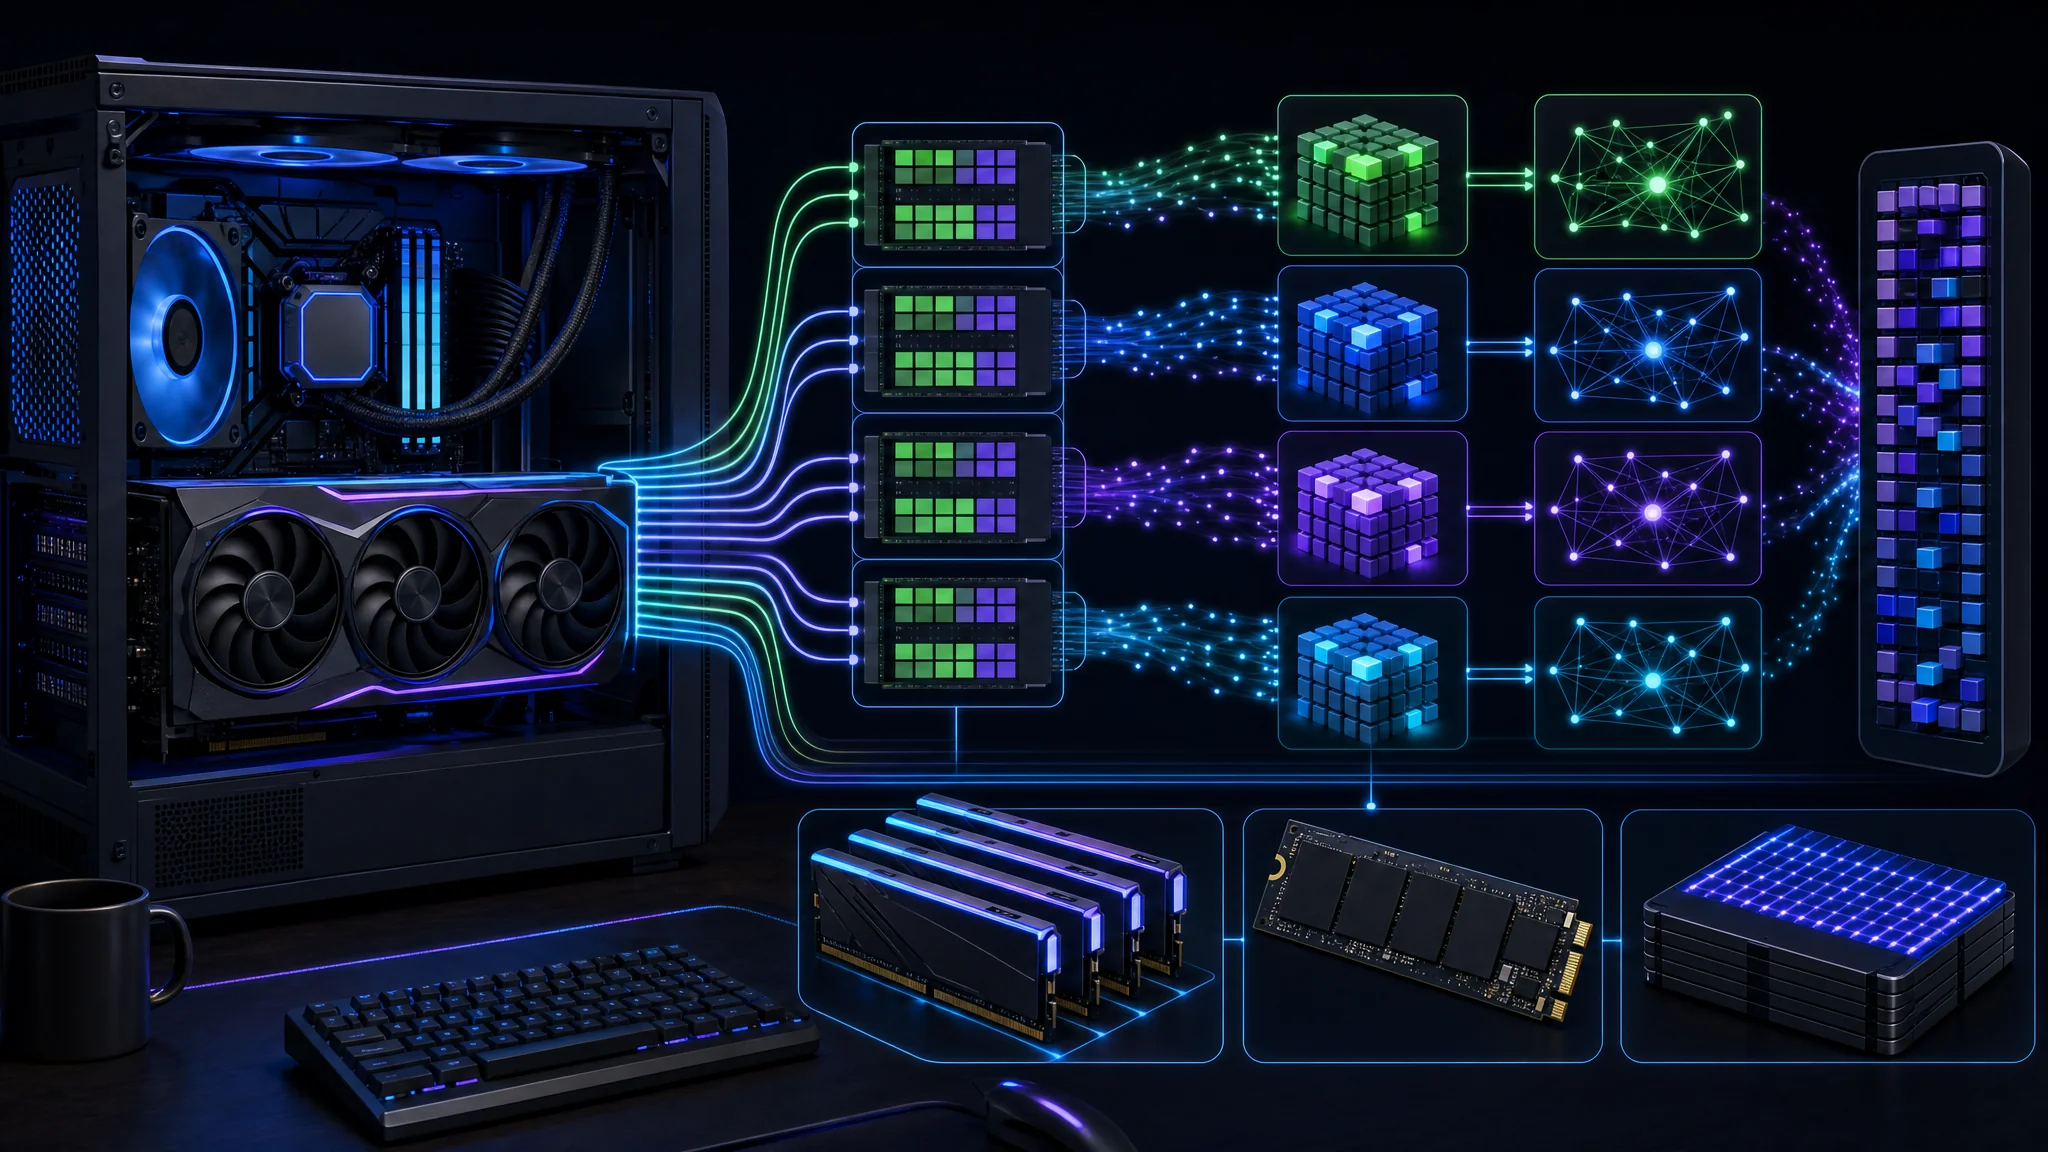
The GPU is one part of the inference system, alongside CPU execution, system RAM, and storage
La réutilisation des prompts modifie la vitesse
Un agent de codage fonctionne en boucle : il lit la tâche, demande une action à un outil, reçoit son résultat et choisit l’action suivante. Le contenu des fichiers, les erreurs et les sorties de tests s’accumulent dans la conversation. Les agents condensent ou sélectionnent aussi le contexte, donc toutes les implémentations ne renvoient pas indéfiniment un historique complet et inchangé.
Le préremplissage traite les tokens d’entrée avant la génération. Le décodage produit la réponse. Un système dont le décodage est rapide mais qui répète un préremplissage lent vous fait encore attendre entre les appels d’outils.
La mesure rapportée pour 44K tokens utilisait la réutilisation du préfixe. Strata réutilisait le contenu de conversation déjà traité, et le prompt croissant était prêt en environ une à trois secondes. C’est un élément utile pour une session d’agent continue. Ce n’est pas la preuve que 44 000 tokens entièrement nouveaux ont été traités depuis zéro en une seconde.
| Mesure | À enregistrer |
|---|---|
| Prompt froid | Temps pour un contenu nouveau sans état de préfixe réutilisable |
| Continuation chaude | Temps après l’ajout d’un résultat d’outil au contexte existant |
| Vitesse de génération | Tokens par seconde pendant la réponse |
| Durée de la tâche | Planification, génération, outils, tests et nouvelles tentatives réunis |
Deux caches servent des objectifs différents. Le cache d’experts garde les poids fréquemment utilisés près du calcul GPU. La réutilisation du préfixe évite de refaire le travail sur les entrées précédentes. Un taux élevé de succès du cache d’experts ne prouve pas un succès du cache de prompt.
Ce que les tâches ont démontré
| Tâche | Durée rapportée | Résultat rapporté |
|---|---|---|
| Créer un gestionnaire de tâches | 3m 38s | API Express, interface, 5/5 tests |
| Corriger l’édition et ajouter des dates | 4m 58s | Modifications terminées, 6/6 tests |
| Ajouter l’import/export et l’empaquetage | 3m 48s | 7/7 tests, build Docker non vérifié |
| Jeu de course, première tentative | 6m 35s | Sortie épuisée pendant le raisonnement, aucun code |
| Jeu de course, nouvelle tentative budgétée | 4m 51s | Jeu généré, syntaxe JavaScript vérifiée |
Le fichier de résultats publié indique des vitesses de sortie de 48 à 52 tokens par seconde pour la première tâche, de 40 à 43 pour la deuxième et de 37 à 44 pour la troisième. « Jusqu’à 52 » est un pic dans ces observations, pas un débit maintenu pour chaque tâche.
Les trois premières tâches prolongent une seule application. Les comptes 5/5, 6/6 et 7/7 décrivent des suites de tests successives. Leur addition ne démontre pas 18 capacités indépendantes. Les tests écrits par le même agent demandent aussi une revue de leur couverture et de leurs assertions.
La récupération de l’environnement faisait partie du travail. L’agent s’est remis d’une commande shell inappropriée et a identifié un serveur d’application obsolète pendant les tests. Ces comportements sont utiles, mais l’arrêt d’un processus existant demande des permissions délibérées dans un environnement de développement partagé.
Docker reste non vérifié. L’agent a écrit un Dockerfile, mais ne disposait pas d’un moteur Docker actif pour le build. Des tests applicatifs réussis hors du conteneur ne prouvent pas qu’une image fonctionne. La nouvelle tentative du jeu a vérifié la syntaxe et ouvert un navigateur, tandis que l’agent ne disposait pas de confirmation visuelle directe du jeu.
Réserver de l’espace pour la sortie
{
  "reasoning_budget_tokens": 8000
}
Fusionnez ce réglage dans la configuration strata-iq3_s.json existante, en conservant ses autres champs, puis redémarrez le modèle Strata sélectionné. Il s’agit d’un réglage Strata, pas d’un remplacement du fichier de configuration OpenCode. Vérifiez le budget actif dans la sortie de démarrage.
Strata documente un budget de raisonnement strict qui termine la phase de réflexion et passe vers une réponse. Une valeur au niveau de la requête remplace la valeur par défaut configurée. Ce réglage diffère d’une instruction générale d’effort de raisonnement comme low ou high.
La première tentative du jeu a épuisé son allowance de 16 384 tokens pendant la planification. La nouvelle tentative a appliqué un budget de réflexion de 8 000 tokens et fourni du code. Cela justifie un raisonnement borné pour cette charge. Cela ne fait pas de 8 000 le meilleur réglage pour toutes les tâches.
L’allocation de sortie restante est un maximum, pas une garantie de réservation. Si une limite de 8 000 tokens était entièrement consommée sous une limite totale de 16 384, environ 8 384 tokens resteraient avant les autres surcharges. Le journal de résultats indique 11 054 tokens écrits lors de la nouvelle tentative, sans répartition complète entre raisonnement et code. N’interprétez pas ce résultat comme 8 000 tokens de raisonnement plus 11 054 tokens de code sous la même limite.
Utilisez un budget plus petit pour les modifications étroites, puis testez des budgets plus grands pour les tâches demandant davantage d’analyse. Inspectez la sortie complète du fichier, l’état de fin et les résultats des tests. Une planification plus longue n’est utile que si elle améliore la modification livrée.
Connecter Strata et OpenCode
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
Il s’agit du point d’entrée de l’installation Linux. Consultez les instructions actuelles et utilisez START-HERE.bat pour le chemin Windows documenté. Sélectionnez la variante originale Qwen3.8-Flash-Next IQ3_S et un contexte de 65 536 tokens pour approcher la configuration rapportée. Enregistrez la version du moteur et les fichiers du modèle avec vos notes de benchmark.
npm install -g opencode-ai
Installez OpenCode avec ses
instructions officielles
. Dans un terminal séparé, définissez STRATA_BASE_URL comme l’URL de base de l’API locale affichée par Strata, avec son suffixe /v1. Gardez l’inférence liée à la machine locale pour cette configuration.
{
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata local",
      "options": {
        "baseURL": "{env:STRATA_BASE_URL}",
        "apiKey": "local"
      },
      "models": {
        "qwen3.8-flash-next-iq3_s": {
          "name": "Qwen3.8-Flash-Next IQ3_S",
          "limit": { "context": 65536, "output": 16384 }
        }
      }
    }
  },
  "model": "strata/qwen3.8-flash-next-iq3_s"
}
Fusionnez le bloc provider dans ~/.config/opencode/opencode.json, en conservant les réglages existants. Cela adapte l’
exemple de configuration publié
en chargeant le point de terminaison local depuis une variable d’environnement. OpenCode documente les
fournisseurs personnalisés
et la
substitution d’environnement
.
local est un identifiant fictif, conforme à l’exemple de configuration locale sans authentification. Il ne sécurise pas un serveur. Si votre instance Strata active l’authentification, fournissez son identifiant configuré avec le mécanisme de secret local approprié.
Démarrez opencode dans une copie jetable d’un projet et sélectionnez le modèle configuré. Vérifiez le fournisseur sélectionné avant d’envoyer du code. La déclaration du contexte côté client n’augmente pas le contexte configuré sur le serveur, et une fenêtre de 65 536 tokens ne laisse pas 65 536 tokens pour l’entrée lorsqu’il faut aussi de la place pour la sortie.
Inférence locale et permissions
{
  "permission": {
    "edit": "ask",
    "bash": "ask"
  }
}
Fusionnez ces permissions initiales dans la configuration OpenCode pendant l’évaluation de l’agent. La documentation des permissions décrit les contrôles disponibles. Les modifications de fichiers et l’exécution shell affectent votre machine, quel que soit l’endroit où l’inférence s’exécute.
L’inférence locale ne rend pas tous les outils locaux. Les téléchargements de paquets, les outils web, les intégrations externes et le partage facultatif impliquent toujours des services réseau. Examinez les outils activés avant de traiter des dépôts privés. « Le modèle s’exécute localement » est une affirmation plus limitée que « rien ne quitte l’ordinateur ».
Dépanner le premier lancement
| Symptôme | Première vérification |
|---|---|
| Fournisseur indisponible | Strata fonctionne et la variable d’environnement atteint le processus OpenCode |
| Modèle absent de la sélection | L’identifiant du fournisseur et celui du modèle correspondent à la configuration enregistrée |
| Erreur de limite de contexte | La longueur du prompt et la sortie demandée tiennent dans la fenêtre active du serveur |
| Planification sans code | Budget de raisonnement, limite totale de sortie et état de fin |
| Continuation lente | Réutilisation du préfixe, pression mémoire, comportement du cache d’experts et processus concurrents |
| Échec de la commande Docker | Un moteur fonctionnel est disponible, pas seulement son client en ligne de commande |
Changez un seul réglage à la fois et répétez la même tâche depuis un état de départ sauvegardé. Cela sépare une amélioration de configuration d’un prompt différent ou d’un test plus facile.
Remplace-t-il un abonnement ?
| La configuration locale mérite un test | Garder une autre option disponible |
|---|---|
| Matériel compatible déjà disponible | Acheter du matériel uniquement pour une charge non testée |
| Modifications applicatives délimitées | Grands dépôts inconnus et migrations difficiles |
| Tests d’acceptation reproductibles | Tâches sans moyen fiable de vérifier la correction |
| Temps pour la maintenance du moteur | Travail demandant peu de préparation et de support |
L’absence de dépense d’API compte, surtout lorsque le matériel est déjà disponible. Elle exclut l’électricité, la dépréciation du matériel, le stockage et le temps consacré à la maintenance de l’environnement. Le champ de coût nul affiché ne mesure pas non plus ces dépenses.
Une comparaison d’abonnement demande des tâches identiques. Utilisez le même dépôt initial, les mêmes instructions et les mêmes contrôles d’acceptation dans les deux systèmes. Notez les nouvelles tentatives et les corrections humaines avec la durée écoulée. Incluez la première tentative ratée du jeu lors de l’évaluation du flux complet, au lieu de ne rapporter que la nouvelle tentative réussie.
Un agent local utile n’a pas besoin d’être supérieur partout. S’il traite de façon fiable vos modifications courantes et laisse un petit groupe de tâches difficiles à un autre outil, il modifie déjà les services payants dont vous avez besoin. Décidez à partir du travail accepté sur vos propres projets.
Démonstration et prochaines étapes
À voir ensuite : La démonstration d’un agent de codage local 125B . Les mesures rapportées ci-dessus appartiennent au test publié et non à un benchmark indépendant réalisé pour cet article.
- Reproduisez une petite tâche avec des critères d’acceptation fixes et une révision de départ sauvegardée.
- Mesurez les tours froids et chauds au lieu de considérer la réutilisation du préfixe comme une vitesse de préremplissage à froid.
- Vérifiez séparément l’empaquetage avec un build d’image réussi, un démarrage et des contrôles au niveau du conteneur.
- Inspectez les tests générés et ajoutez les cas que l’implémentation n’avait pas prévus.
- Comparez le travail terminé avec votre outil de codage actuel avant de modifier vos abonnements.
Pour planifier le matériel, lisez le guide sur les modèles IA locaux et le contexte GPU . Pour le comportement des modèles hébergés, consultez le routage des fournisseurs et les coûts OpenRouter .
Related Posts